 模型
83 万下载的开源视频模型天花板——文生视频/图生视频/音视频同步/4K 20 秒,8GB 显存量化可跑

 软件
33B 开源全模态视频模型,从零部署到 Motion Context 长视频拼接、低显存优化、fal.ai H3 Max 实时直播,一份搞定
 Skills
字级配音同步、七层反PPT镜头系统、三重验收自动返工,把Claude Code/Codex变成口播视频动效工作室
 硬件
64GB 统一内存本地跑 27B,252 次请求零报错。低并发看响应,高并发看总量,甜蜜区在 N≤4
 随笔
首个开源全能参考视频模型:消费级显卡可跑,效果≈Seedance 2.0 Fast 八成、成本仅十分之一。附Seedance/可灵/万相/LTX/Veo/Grok/FLUX3逐家盘点
 模型
FLUX 1/2 团队新作:图像/视频/音频联合训练的世界模型,视频+原生音频最长 20 秒,Early Access 已开放
 软件
策划/分镜/生成/剪辑/交付全流程 Agent 串联,无限画布+技能插件生态+商业模板;配开源 H3 视频模型,768P 0.5元/秒、2K 0.8元/秒,年卡低至0.4元/秒
 教程
Windows 版 Codex 通过桌面图标切换 OpenAI、DeepSeek、本地 Qwen,并为不同上下文窗口设置独立自动压缩阈值。
 教程
中文口播稿出海东南亚怎么配音?覆盖云端统一方案(Qwen-Audio-3.0-TTS/ElevenLabs/MiniMax/豆包)、开源单模型(Scicom/Confucius4)和各语种专用模型(JaiTTS/VieNeu-TTS/Malaysian-TTS),含选型矩阵
 软件
基于 STTN/LaMA/ProPainter 等多算法的视频硬字幕和文本水印去除工具,完全本地运行,支持 Windows/Mac/Linux/Docker
 模型
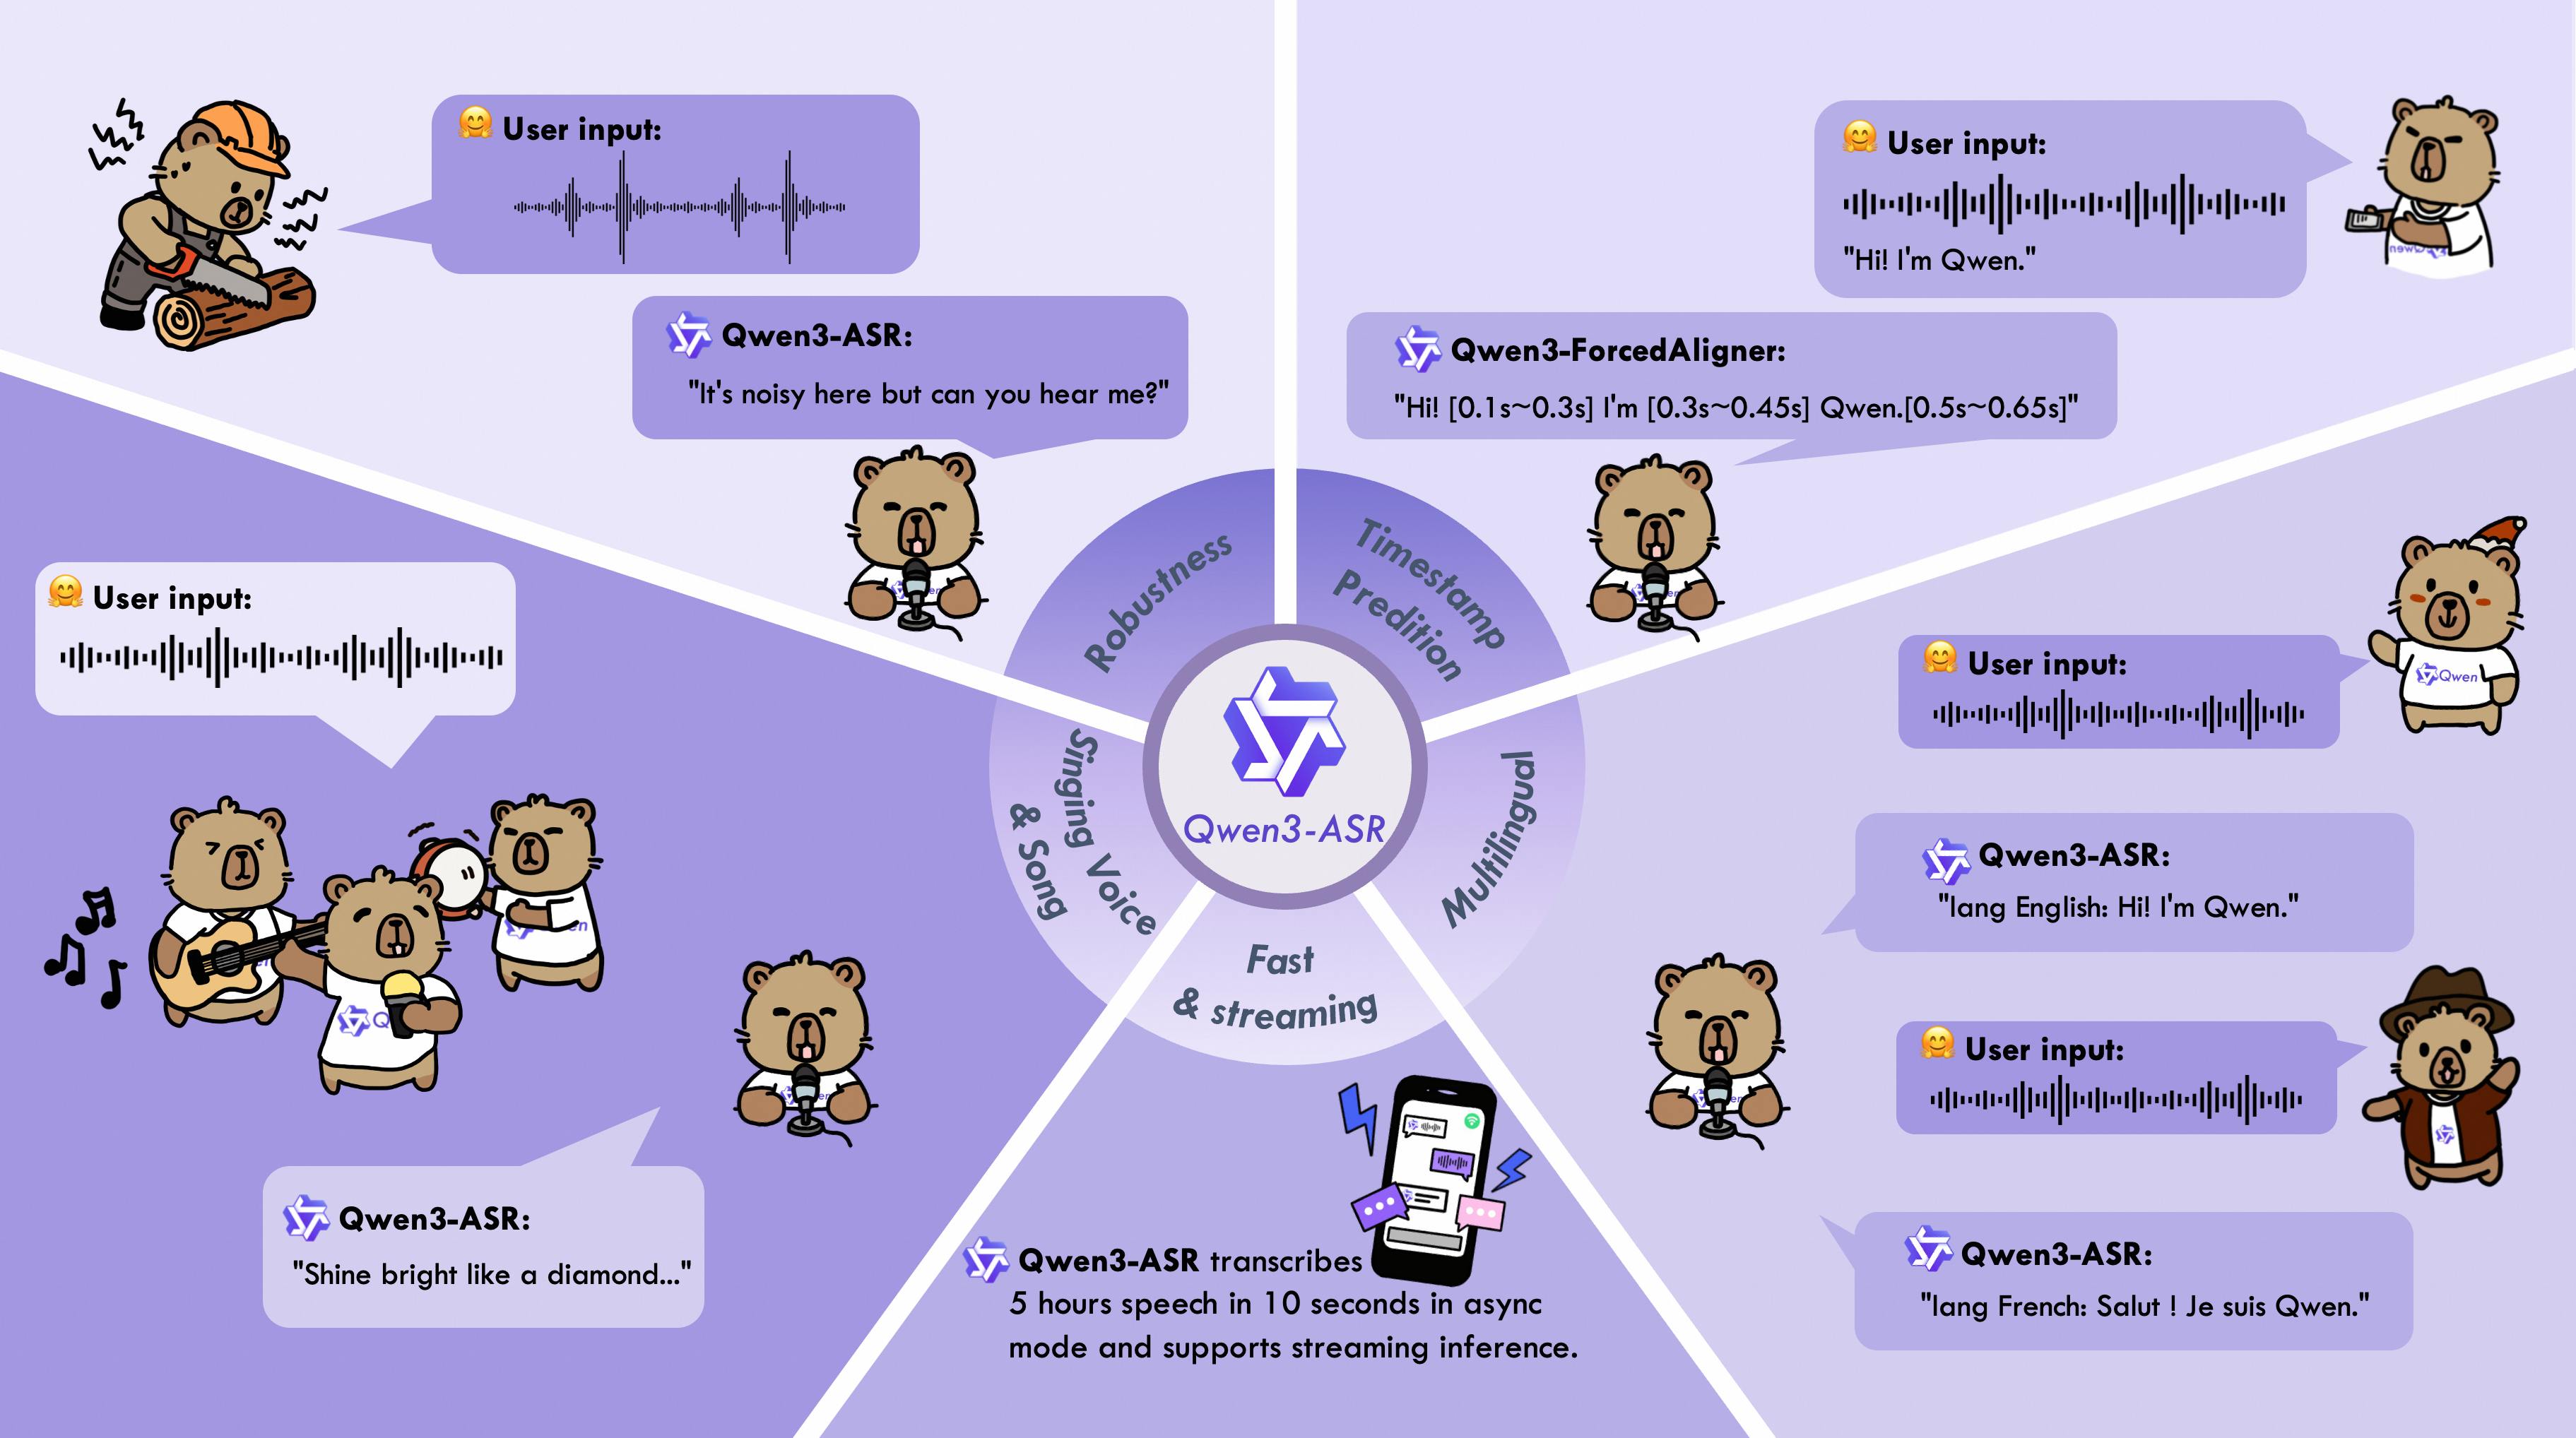
Qwen3-ASR 效率碾压、VibeVoice 长音频分人无敌、Whisper 生态覆盖最广——三大 ASR 各守一象限,谁该装谁
 软件
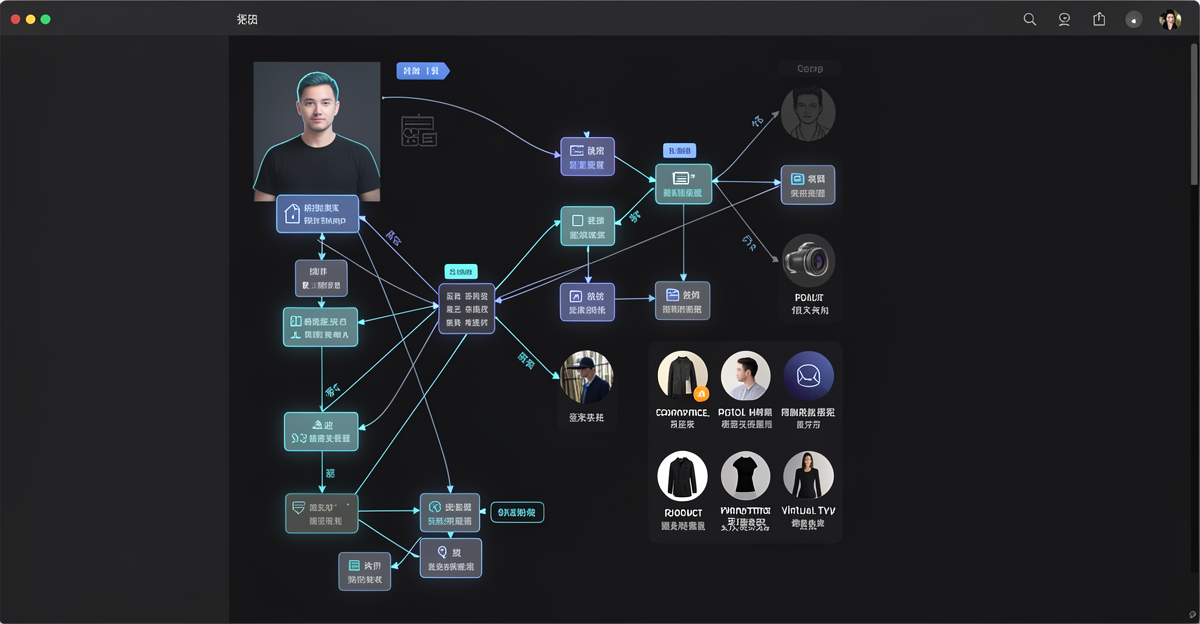
有趣的80后程序员的ComfyUI工作流相册:按日期查换脸、数字人、电商产品图、虚拟试穿流程,照着配节点。