 软件
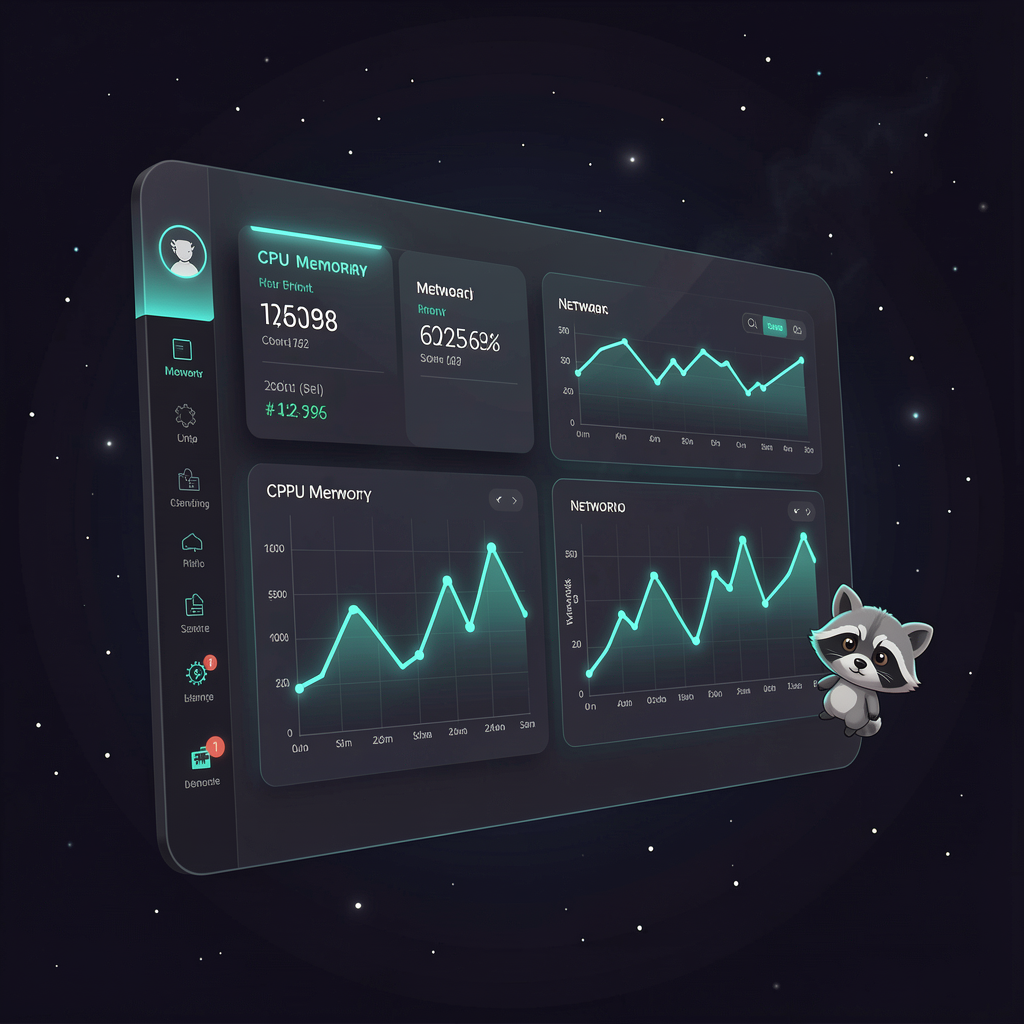
哪吒探针数据不动,前端直接换代:卡片式实时监控+深色模式+手机友好,Docker一条命令或白嫖Vercel/CF部署

 软件
不只量化更是全链路:Dynamic v3.0动态精度+MTP投机解码+Flash Attention加速,llama.cpp/Ollama一键起
 软件
学术派量化天花板:每个张量单独分配精度,同体积比Unsloth高10分,论文代码全公开可自己复刻
 模型
一张 3090 Ti 跑 27B 免审模型:改写/翻译类比原双卡快 2.2 倍,日常对话快 32%。代价是量化从 8 位降到 4 位,且质量尚未验证。
 程序员
开源界最能自己干活的AI程序员,8.8万star,issue丢给它就自己改代码跑测试,免费自托管!
 酷站
不知道 System One 决策模型能干嘛?这个策展站把 194 个真实 Jev 项目、演示和作者一站收齐,找灵感的最佳入口
 MacOS
LM Studio跑MLX模型的官方引擎:多轮对话缓存命中秒回、同图追问只算一次视觉编码。99%的人不用装(LM Studio自带),自建MLX服务的值得抄它的缓存设计。
 源码
做企业AI视频踩坑沉淀的开源包:543条实测prompt按官方公式收录,Action每周巡检防过期,跨模型prompt翻译器+15模型选型顾问,做AI视频的Star一份。
 酷站
AI总答非所问?不是模型不行是指令没写清。这站按场景收好了提示词模板——论文润色、代码debug、简历优化,找到就抄,一键复制贴给ChatGPT/DeepSeek直接用,不用注册。
 模型
同一个模型有 4bit/8bit/免审版,怎么选?一句话:稠密选小、MoE 选大。附下载地址与实测速度;2026-09 补测 oMLX 引擎,修正「换引擎不会变快」的旧结论。
 健康
外网传疯的斯坦福教授胡伯曼访谈:会硬扛的人输给了会关机的人。一秒入睡的眼球关机法、海豹突击队的左右栏法则,不花一分钱立刻能用。
 程序员
从零手搓的C++/CUDA推理引擎,只认RTX 5090一张卡:Qwen3.8-27B八路并发767 tok/s、AIME双96.7%不掉点,240K上下文还能看图看视频,5090党的天花板玩法。
 随笔
RLHF共同发明人新公司首作:不做聊天只做结构化决策,概率校准可信到能写进代码阈值,便宜两个数量级
 模型
发布3天下载破150万!54GB的Qwen3.8-27B压到5.9GB还留98.2%智力,传统2bit崩掉的数学题它守住95分,低比特本地部署天花板。
 软件
还在硬啃英文模站?一个油猴脚本让 Civitai 变中文,广告没了,原图直下,逛 LoRA 库舒服多了