 模型
一张 3090 Ti 跑 27B 免审模型:改写/翻译类比原双卡快 2.2 倍,日常对话快 32%。代价是量化从 8 位降到 4 位,且质量尚未验证。

 模型
同一个模型有 4bit/8bit/免审版,怎么选?一句话:稠密选小、MoE 选大。附下载地址与实测速度;2026-09 补测 oMLX 引擎,修正「换引擎不会变快」的旧结论。
 模型
发布3天下载破150万!54GB的Qwen3.8-27B压到5.9GB还留98.2%智力,传统2bit崩掉的数学题它守住95分,低比特本地部署天花板。
 模型
国产 3D 大模型的天花板:一张图几十秒出生产级 3D 模型,SIGGRAPH 最佳论文团队出品,先试再说
 模型
Google Research 时序预测模型:丢历史曲线直接出未来预测+置信区间,1.3GB 零样本免训练,注意非商用许可
 模型
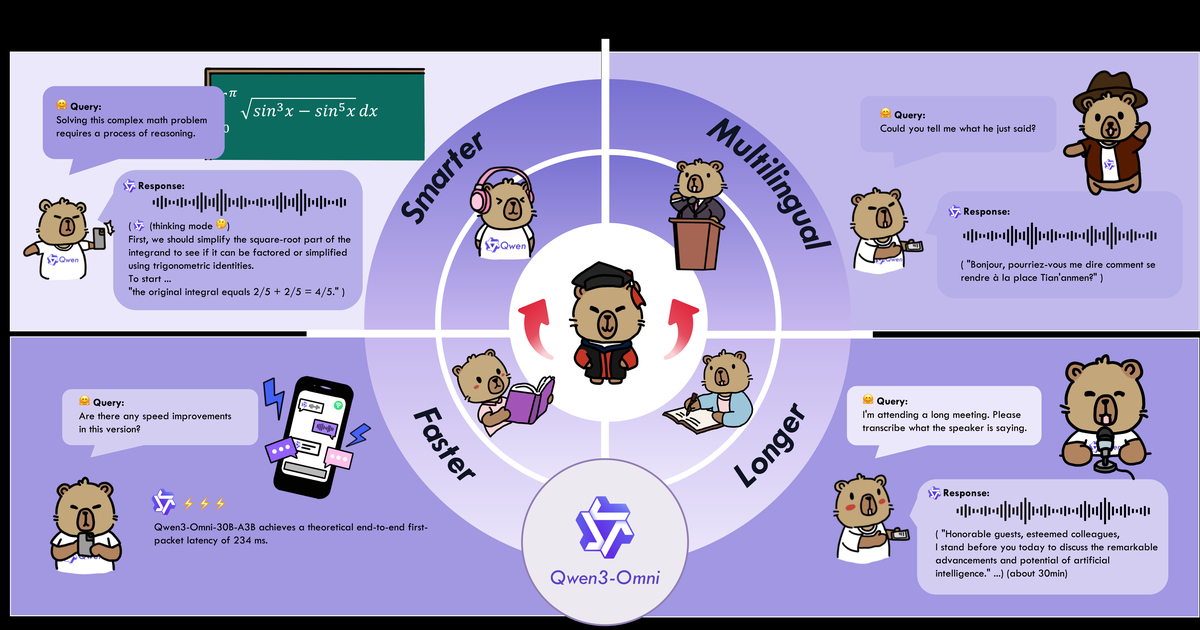
甩一段视频进去,画面内容、背景音乐、音效、对白全给你分析出来——阿里原生全模态模型,30B只激活3B,还能直接用语音回答你,Apache 2.0
 模型
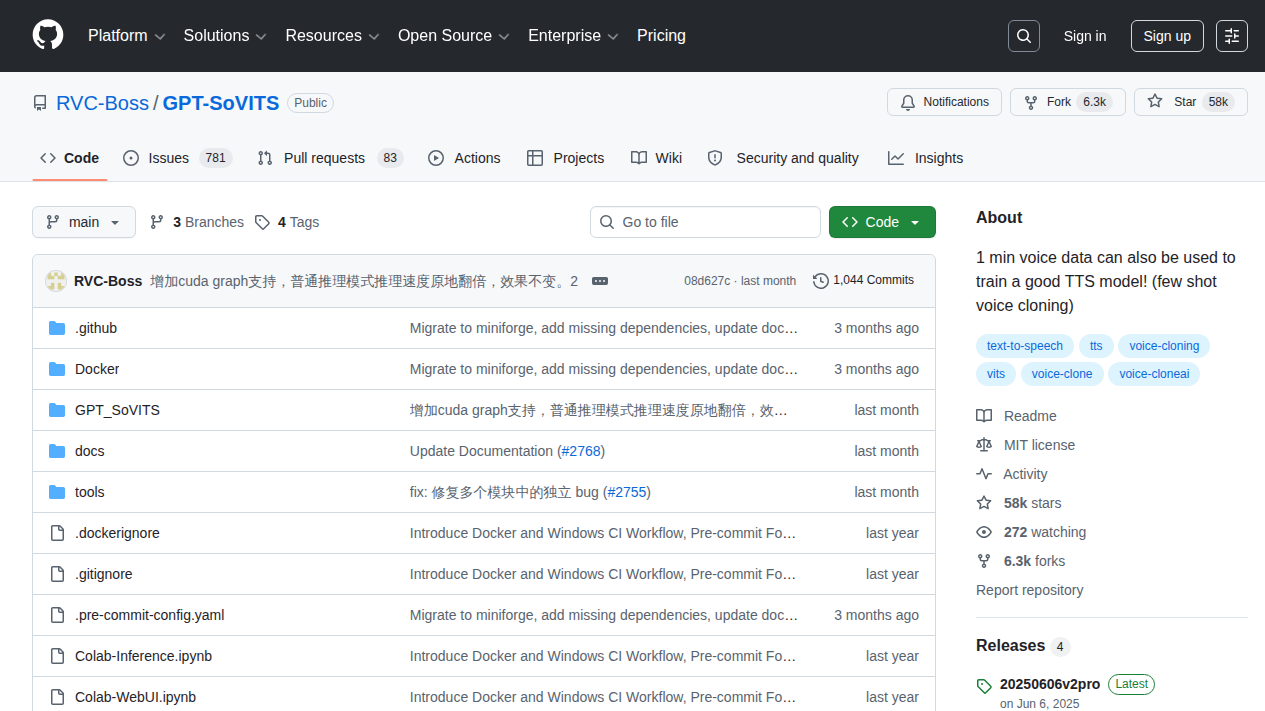
5秒样本零样本TTS,1分钟数据微调即可克隆声音。支持中英日韩粤跨语言推理,集成WebUI工具链,58k Stars
 模型
83 万下载的开源视频模型天花板——文生视频/图生视频/音视频同步/4K 20 秒,8GB 显存量化可跑
 模型
FLUX 1/2 团队新作:图像/视频/音频联合训练的世界模型,视频+原生音频最长 20 秒,Early Access 已开放
 模型
Qwen3-ASR 效率碾压、VibeVoice 长音频分人无敌、Whisper 生态覆盖最广——三大 ASR 各守一象限,谁该装谁
 模型
十几个去审查版里口碑最干净的一版,MLX 786赞/FP8 715赞双第一,红队探针0拒绝且不变笨;附 JonathanColetti/OBLITERATUS/huihui 等6家横评
 模型
Qwen3.6-27B正统后继:原生多模态+混合线性注意力架构,262K上下文,终端编程基准超Opus 4.6 Max,Apache 2.0可商用,量化后16GB内存可跑
 模型
微软研究院 4B 参数 image-to-3D 模型:O-Voxel 表示搞定任意拓扑+完整 PBR 材质,512³ 仅 3 秒,24GB 显存可本地跑,MIT 协议全开源
 模型
字节 Seedance 2.5 正式上线,Higgsfield 同步启动 100万美元 AI 电影竞赛,比赛期间不限量免费用


