站内搜索「Omni」共 18 条结果


推荐模型
Omniparse — 将任意文档/图片/音视频解析为LLM友好格式Ingest, parse, and optimize any data format:PDF/Word/PPT/Excel、图片、音频、视频一键转结构化Markdown,专为GenAI框架优化
4个月前
推荐模型
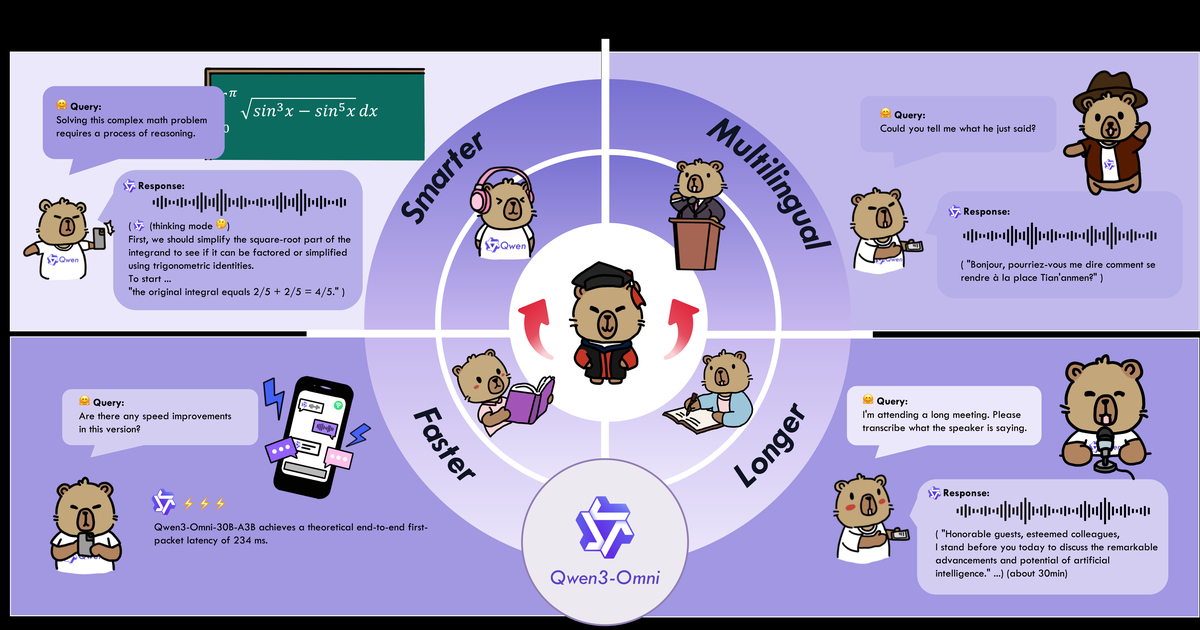
Qwen3-Omni - 30B原生全模态,能看能听还能说甩一段视频进去,画面内容、背景音乐、音效、对白全给你分析出来——阿里原生全模态模型,30B只激活3B,还能直接用语音回答你,Apache 2.0
26天前
推荐模型
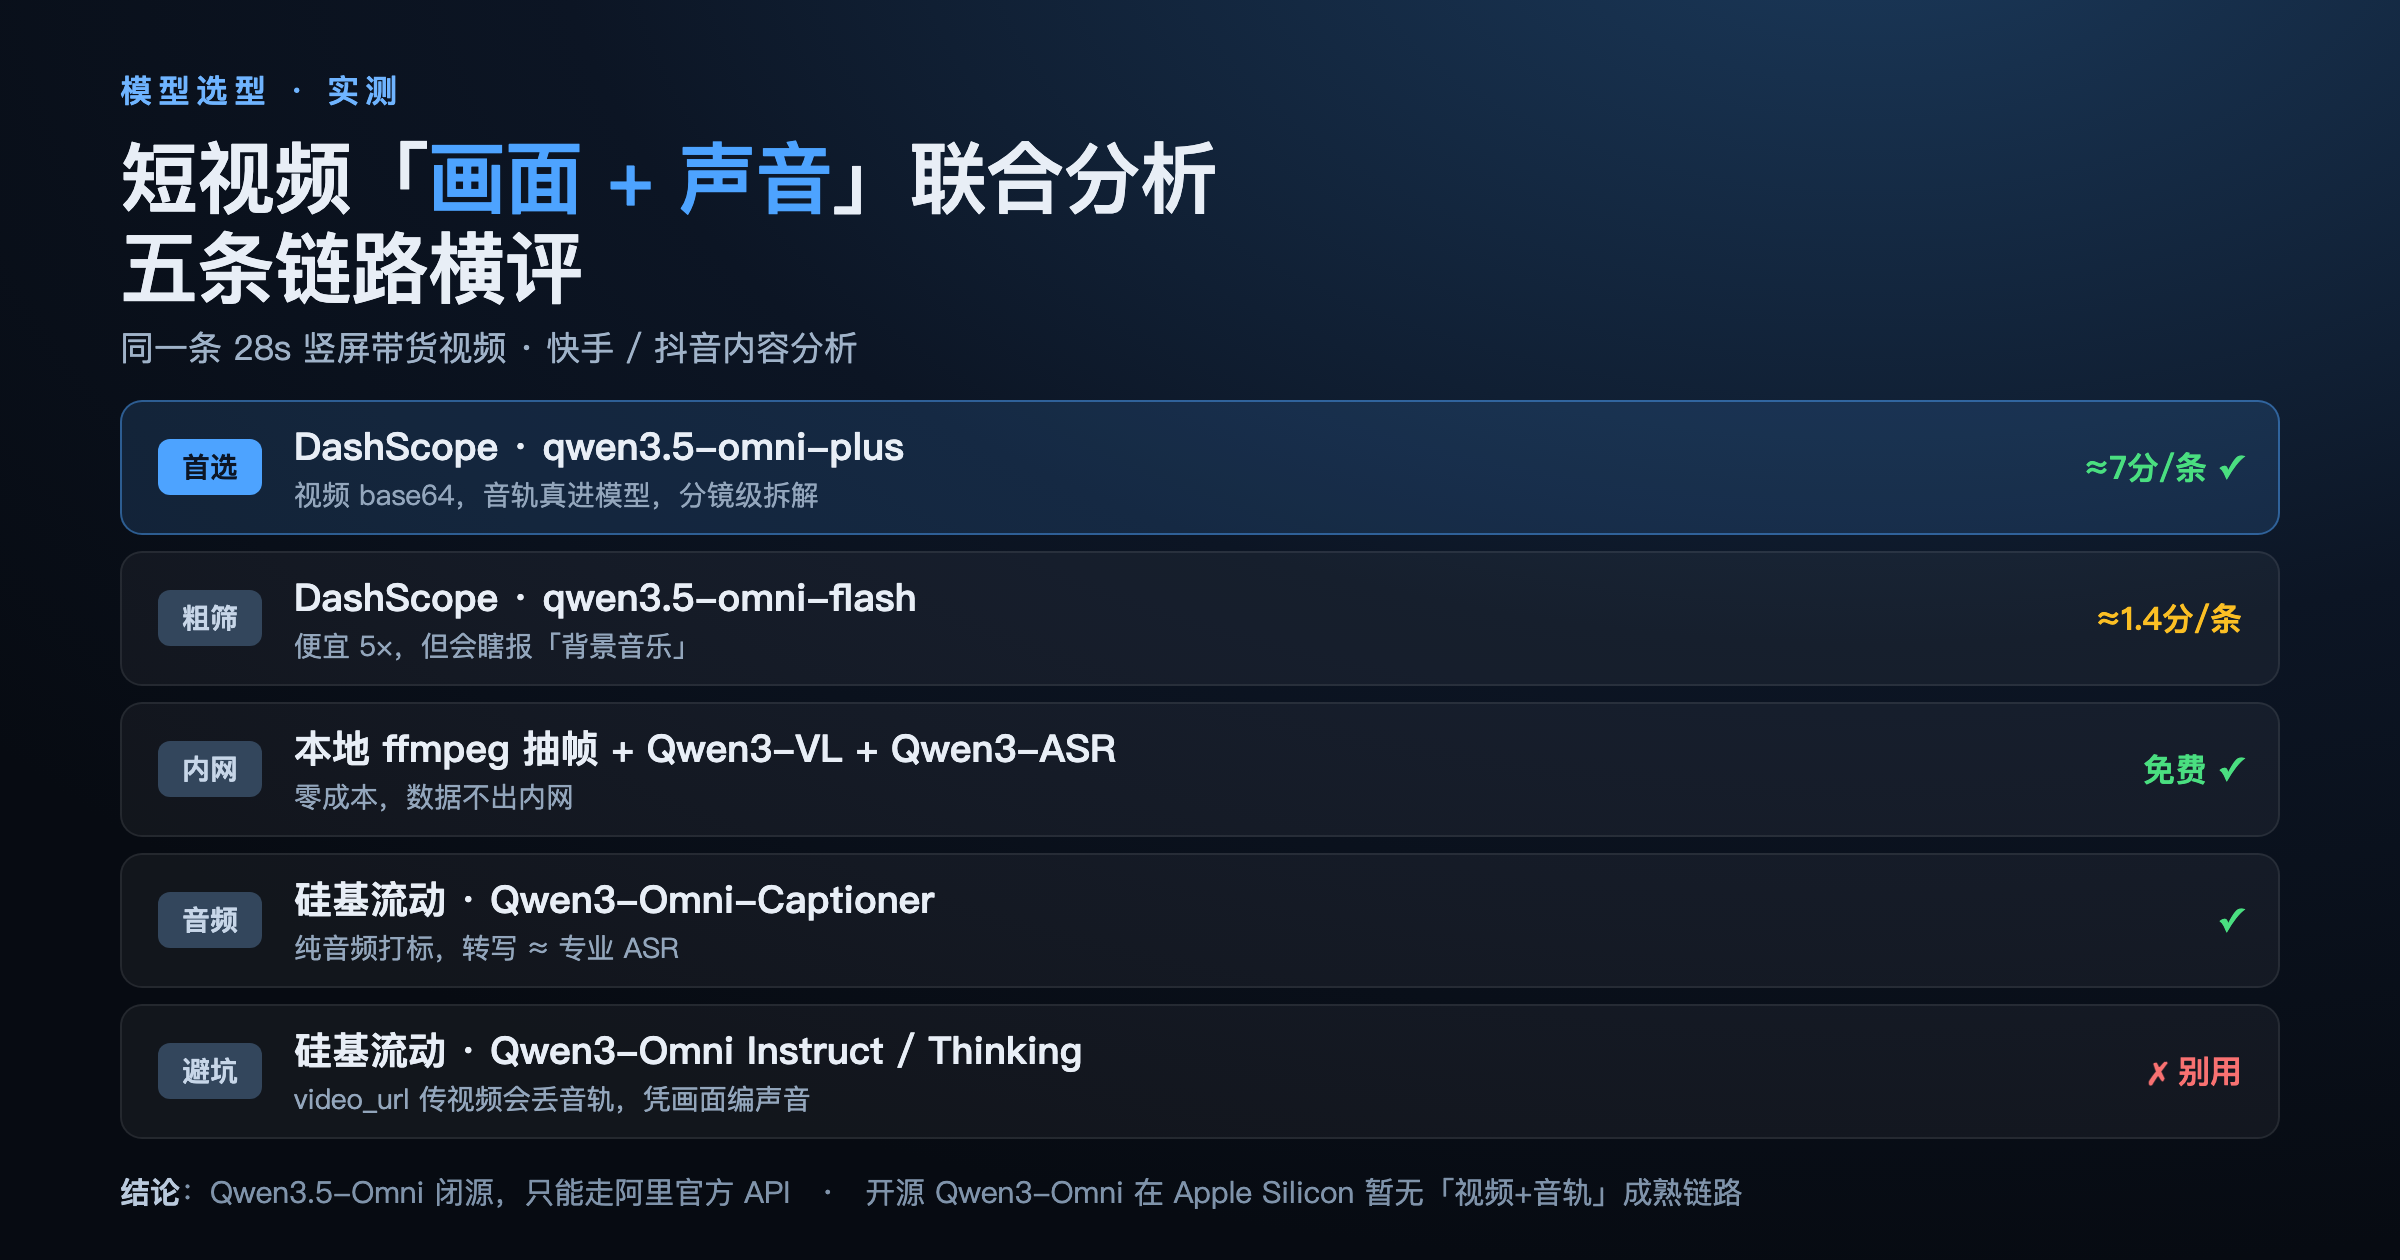
短视频音视频联合分析:Qwen3.5-Omni 五条链路实测与选型要同时读画面+声音分析快手/抖音短视频,实测硅基流动 Qwen3-Omni、DashScope Qwen3.5-Omni flash/plus、本地抽帧+ASR 五条链路,给出选型建议和避坑点。
26天前

推荐软件
MiniMax H3 完整使用教程:部署、长视频、实时直播33B 开源全模态视频模型,从零部署到 Motion Context 长视频拼接、低显存优化、fal.ai H3 Max 实时直播,一份搞定
28天前
推荐模型
VoxCPM2 - 开源无分词器 TTS 模型,30 语言语音合成与声音克隆OpenBMB 开源的 2B 参数文本转语音模型,支持 30 语言、Voice Design 声音设计、可控声音克隆,48kHz 输出,Apache-2.0 可商业使用
4个月前
推荐软件
TurboOCR — GPU 极限速度的文档解析器OCR/版面/表格/公式全流水线跑在显卡上,PDF 进 Markdown 出,单卡 5090 最快 559 图/秒,比传统 OCR 快 15-90 倍
1个月前
推荐软件
MiniMax Design — AI Agent 商业视频工作台(H3 模型)策划/分镜/生成/剪辑/交付全流程 Agent 串联,无限画布+技能插件生态+商业模板;配开源 H3 视频模型,768P 0.5元/秒、2K 0.8元/秒,年卡低至0.4元/秒
1个月前
推荐模型
FLUX 3 - Black Forest Labs 多模态统一模型,图像视频音频一个架构FLUX 1/2 团队新作:图像/视频/音频联合训练的世界模型,视频+原生音频最长 20 秒,Early Access 已开放
1个月前
推荐软件
LocalMiniDrama本地短剧助手 - 数据不出本机的AI短剧/漫剧工作站:梗概进,成片出本地AI短剧/漫剧工作站:梗概进成片出,剧本→角色→分镜→合成全流程,数据不出本机,开源免费无订阅,模型API自己接
12天前

推荐程序员
MinerU - 文档解析引擎开源文档解析引擎,OpenDataLab 出品 78k Star。PDF/Word/PPT/Excel/图片一键转 LLM 友好的 Markdown/JSON,公式转 LaTeX、表格转 HTML、跨页表格合并、109 语言 OCR;Pipeline 后端纯 CPU 可跑,VLM 后端精度 95+,另有 mineru.net 在线服务免部署
5个月前
推荐模型
Qwen3.8-27B - 27B多模态新王,终端编程超Opus 4.6 MaxQwen3.6-27B正统后继:原生多模态+混合线性注意力架构,262K上下文,终端编程基准超Opus 4.6 Max,Apache 2.0可商用,量化后16GB内存可跑
1个月前
推荐教程
东南亚口播配音选型:越南语/马来语/泰语 TTS 模型横评中文口播稿出海东南亚怎么配音?覆盖云端统一方案(Qwen-Audio-3.0-TTS/ElevenLabs/MiniMax/豆包)、开源单模型(Scicom/Confucius4)和各语种专用模型(JaiTTS/VieNeu-TTS/Malaysian-TTS),含选型矩阵
1个月前