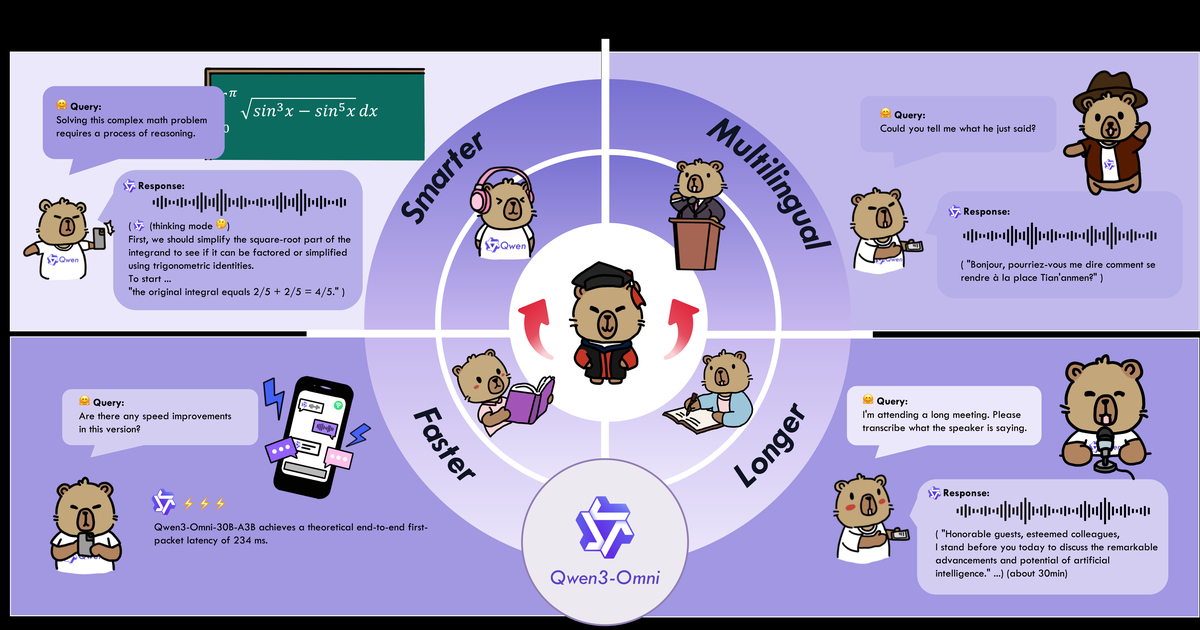
甩一段视频进去,画面内容、背景音乐、音效、对白全给你分析出来——阿里原生全模态模型,30B只激活3B,还能直接用语音回答你,Apache 2.0
Qwen 团队终于把全模态做到了端到端:文本、图片、音频、视频全吃进去,输出文字和自然语音。30B 总参数只激活 3B,MoE 架构,Apache 2.0 可商用。
和之前的 Qwen 多模态模型有什么不同?
之前 Qwen3.6-VL 等是「文本模型 + 视觉适配器」的拼接方案。Qwen3-Omni 是原生端到端训练——文本、图像、音频、视频在同一架构里联合学习,不是后接模块。而且能直接输出语音,不是调 TTS API,是模型原生生成的自然语音。
Thinker–Talker 架构
- Thinker(思考模块):处理多模态理解,带 chain-of-thought 推理
- Talker(输出模块):多 codebook 设计,同时生成文本和语音流,延迟压到最低
- 两个模块协同工作,思考完直接说,不需要额外调用 TTS
能力覆盖面
| 输入 | 输出 | 典型场景 |
|---|---|---|
| 语音 | 文字 | 19 语种语音识别、语音翻译 |
| 语音 | 语音 | 语音对话、同声传译 |
| 音频 | 文字 | 音乐分析、音效描述、音频详细标注 |
| 图片 | 文字 | OCR、图像问答、图像数学推理 |
| 视频 | 文字 | 视频描述、场景转场分析、导航指令生成 |
| 视频+音频 | 文字/语音 | 音视频联合理解、实时多模态对话 |
| 语音 | 函数调用 | 语音驱动的 Agent 行为 |
三个版本
| 版本 | 特点 | 适用 |
|---|---|---|
| Instruct | Thinker + Talker 全量,语音输入+语音/文字输出 | 实时对话、语音助手 |
| Thinking | 只有 Thinker,带 CoT 推理,文字输出 | 复杂推理任务 |
| Captioner | Instruct 微调版,音频细粒度描述、低幻觉 | 音频标注、音效描述 |
跑分亮点
36 个音频/视频基准中 22 个 SOTA、32 个开源 SOTA。ASR、音频理解和语音对话性能对标 Gemini 2.5 Pro。119 种文本语言、19 种语音输入语言、10 种语音输出语言。
部署
HuggingFace Transformers 已合并代码(需从 GitHub 源码安装,PyPI 尚未发版),vLLM 也已支持。MoE 只激活 3B,24GB 显存可跑,门槛和 Qwen3.6-35B-A3B 同级。
GitHub: https://github.com/QwenLM/Qwen3-Omni HuggingFace: https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct 技术报告: 见 GitHub assets/Qwen3_Omni.pdf


暂无评论