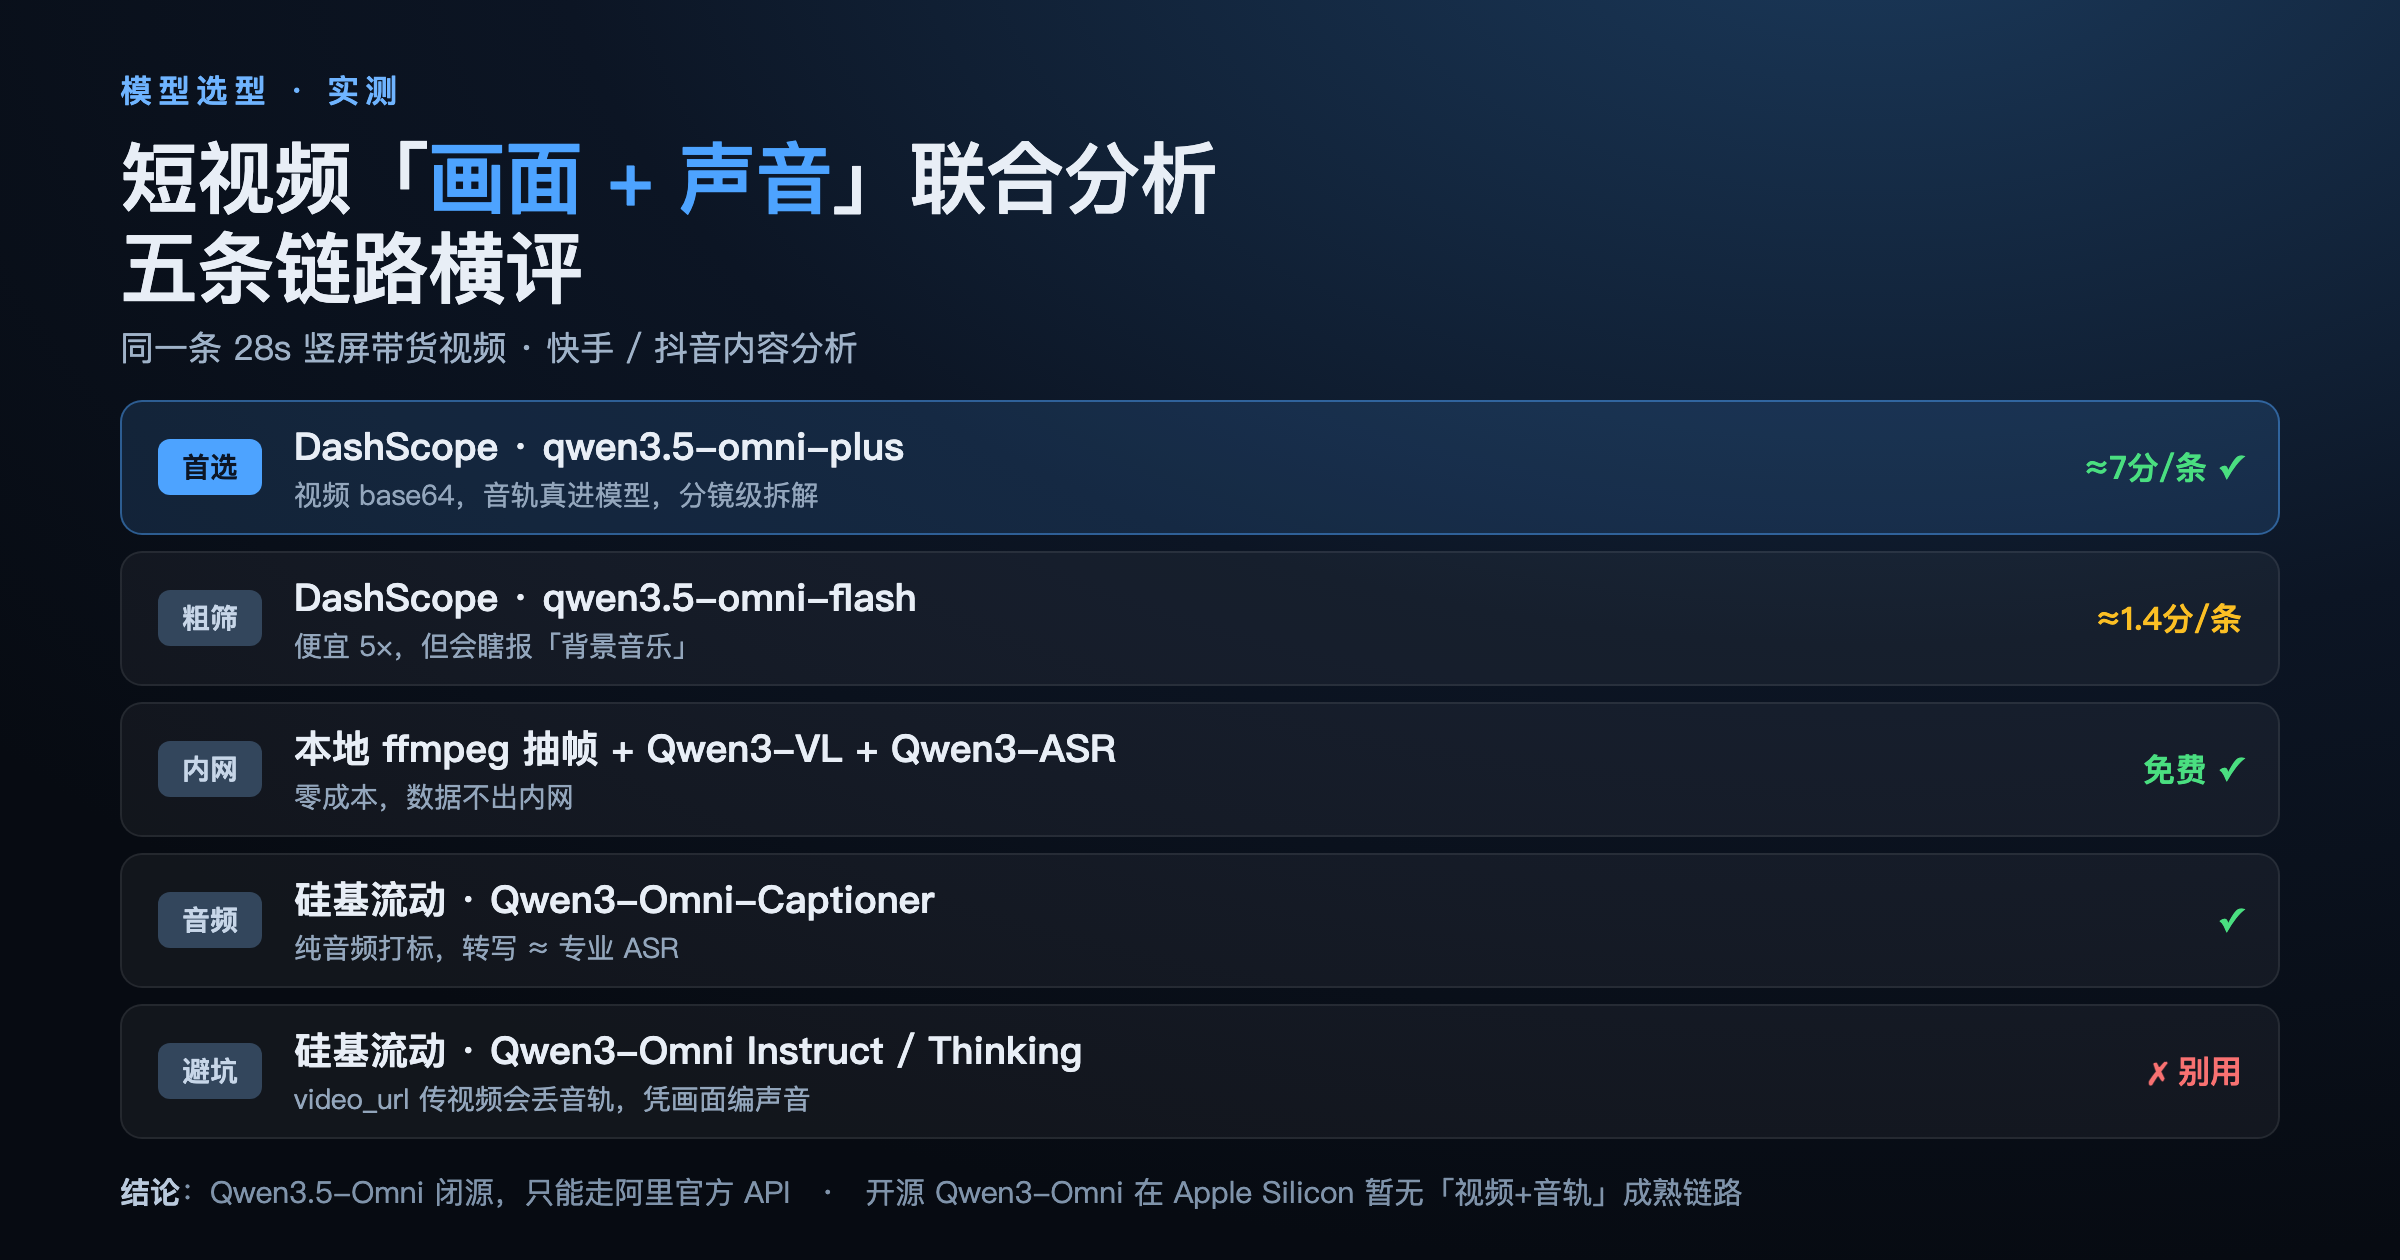
要同时读画面+声音分析快手/抖音短视频,实测硅基流动 Qwen3-Omni、DashScope Qwen3.5-Omni flash/plus、本地抽帧+ASR 五条链路,给出选型建议和避坑点。
需求
批量分析快手 / 抖音短视频,要同时读到画面 + 声音(口播、BGM、音效、语气),而不只是画面。测了几条链路,结论如下。
五条链路横评(同一条 28s 竖屏带货视频)
| 链路 | 音频是否真进模型 | 口播转写 | 单条成本 | 备注 |
|---|---|---|---|---|
硅基流动 Qwen3-Omni-Instruct(视频 base64) | ❌ 丢掉 | 只认出画面字幕、少数句还编错 | ~3k tok | video_url 只传帧,音轨不处理 |
硅基流动 Qwen3-Omni-Thinking(视频 base64) | ❌ 丢掉 | 更差,硬编"背景音乐轻快""刮鱼鳞"等幻觉,思考过程自曝"需要想象配音内容" | ~3k tok(含 ~960 reasoning) | 越推理越自信地编 |
硅基流动 Qwen3-Omni-Captioner(纯音频) | ✅ | ✅ 近乎逐字 + 音色/语气/制作水准描述 | ~1k tok | 只吃音频,≤30s,不接受文字 prompt |
DashScope qwen3.5-omni-flash(视频 base64) | ✅(usage 里 audio_tokens 有值) | ✅ 近乎逐字 | ~1.4 分 | 视频抽帧密度 6× 于硅基流动 |
DashScope qwen3.5-omni-plus(视频 base64) | ✅ | ✅ 近乎逐字 | ~6.7 分 | 修正了 flash 的 BGM 幻觉,给带时间轴的分镜级拆解 |
关键证据:DashScope 返回的 usage 里 prompt_tokens_details 明确分出 video_tokens / audio_tokens,音轨确实被处理;硅基流动的 video_url 链路 prompt 只有 ~2900 token,音频信息基本没进去。
结论
- 一个接口端到端吃短视频(画面 + 声音):用阿里官方 DashScope 的
qwen3.5-omni-plus。它把flash唯一硬伤(瞎报背景音乐)修好了,输出的是分镜级、字幕逐段对齐的拆解。一条短视频约 7 分钱,可接受。 - 大批量粗筛"这条视频讲啥、卖啥品":
qwen3.5-omni-flash,便宜 5 倍,口播转写同样到位。 - 零成本 / 数据不出内网:本地
ffmpeg 抽帧 → Qwen3.6-VL 看画面+Qwen3-ASR 转口播,两段结果拼一起,效果不输托管方案(这条视频字幕≈口播,抽帧就够)。 - 纯音频打标 / 建音频数据集:硅基流动
Qwen3-Omni-Captioner,转写质量 ≈ 专业 ASR,还附带音色语气描述。
避坑
- 硅基流动的 Qwen3-Omni(Instruct/Thinking)不要用
video_urlbase64 传视频做音视频联合分析 —— 音轨会被丢掉,模型转头凭画面编造声音内容,Thinking 因为爱推理编得更狠。要么单独传audio_url,要么直接换 DashScope。 - Qwen3.5-Omni 是闭源的,权重下不到,只能走阿里官方 API;Qwen3-Omni 开源版在 Apple Silicon 上目前没有能跑通"视频 + 音轨"的成熟链路。想自部署做音视频分析这条路暂时不通。
- DashScope 的 omni 模型必须
stream: true,否则报错;-realtime后缀是实时语音对话专用,不是拿来批量分析视频的。 - 即使
qwen3.5-omni-plus,"有没有 BGM / 音效细节"这类仍偶有小幻觉,音频关键信息建议留一道复核。
价格参考(DashScope 国际站,每百万 token 输入/输出)
qwen3.5-omni-flash:约 $0.10 / $0.40qwen3.5-omni-plus:约 $0.40 / $2.40(256K 以上输入档位上浮)- 两档都是 256K 上下文;flash 视频上限 256MB / 150s,plus 2GB / 1 小时


暂无评论