站内搜索「场景」共 273 条结果
Cloudflare Wallets
推荐api
Cloudflare Wallets
面向 AI Agent 的可编程钱包,稳定币微支付 + x402 协议,让智能体拥有原生身份与支付能力
1个月前
RVC WebUI - 开源语音转换/AI翻唱框架
推荐软件
RVC WebUI - 开源语音转换/AI翻唱框架
检索式变声框架:10分钟语音训练音色模型,训练推理一体WebUI,37k stars
1个月前
妙手ERP - 跨境电商多平台店铺一体化管理
推荐电商
妙手ERP - 跨境电商多平台店铺一体化管理
110万卖家在用的跨境ERP,采集上货订单利润一站搞定,还集成了不少电商AI工具
1个月前
Headscale — Tailscale 自建控制服务器,无限设备的私有 Mesh VPN
推荐软件
Headscale — Tailscale 自建控制服务器,无限设备的私有 Mesh VPN
Tailscale 控制服务器的开源替代,自建私有 Mesh VPN 协调端,无限设备
1个月前
NetBird — 全栈开源 Mesh VPN,内置管理面板和 OIDC 身份集成
推荐软件
NetBird — 全栈开源 Mesh VPN,内置管理面板和 OIDC 身份集成
全栈开源 Mesh VPN 平台,内置管理面板和 OIDC 集成,从零构建的自托管 WireGuard 网络方案
1个月前
LTX-2.5 - Lightricks 开源视频生成模型,22B 参数音视频同步
推荐模型
LTX-2.5 - Lightricks 开源视频生成模型,22B 参数音视频同步
83 万下载的开源视频模型天花板——文生视频/图生视频/音视频同步/4K 20 秒,8GB 显存量化可跑
1个月前
TurboOCR — GPU 极限速度的文档解析器
推荐软件
TurboOCR — GPU 极限速度的文档解析器
OCR/版面/表格/公式全流水线跑在显卡上,PDF 进 Markdown 出,单卡 5090 最快 559 图/秒,比传统 OCR 快 15-90 倍
1个月前
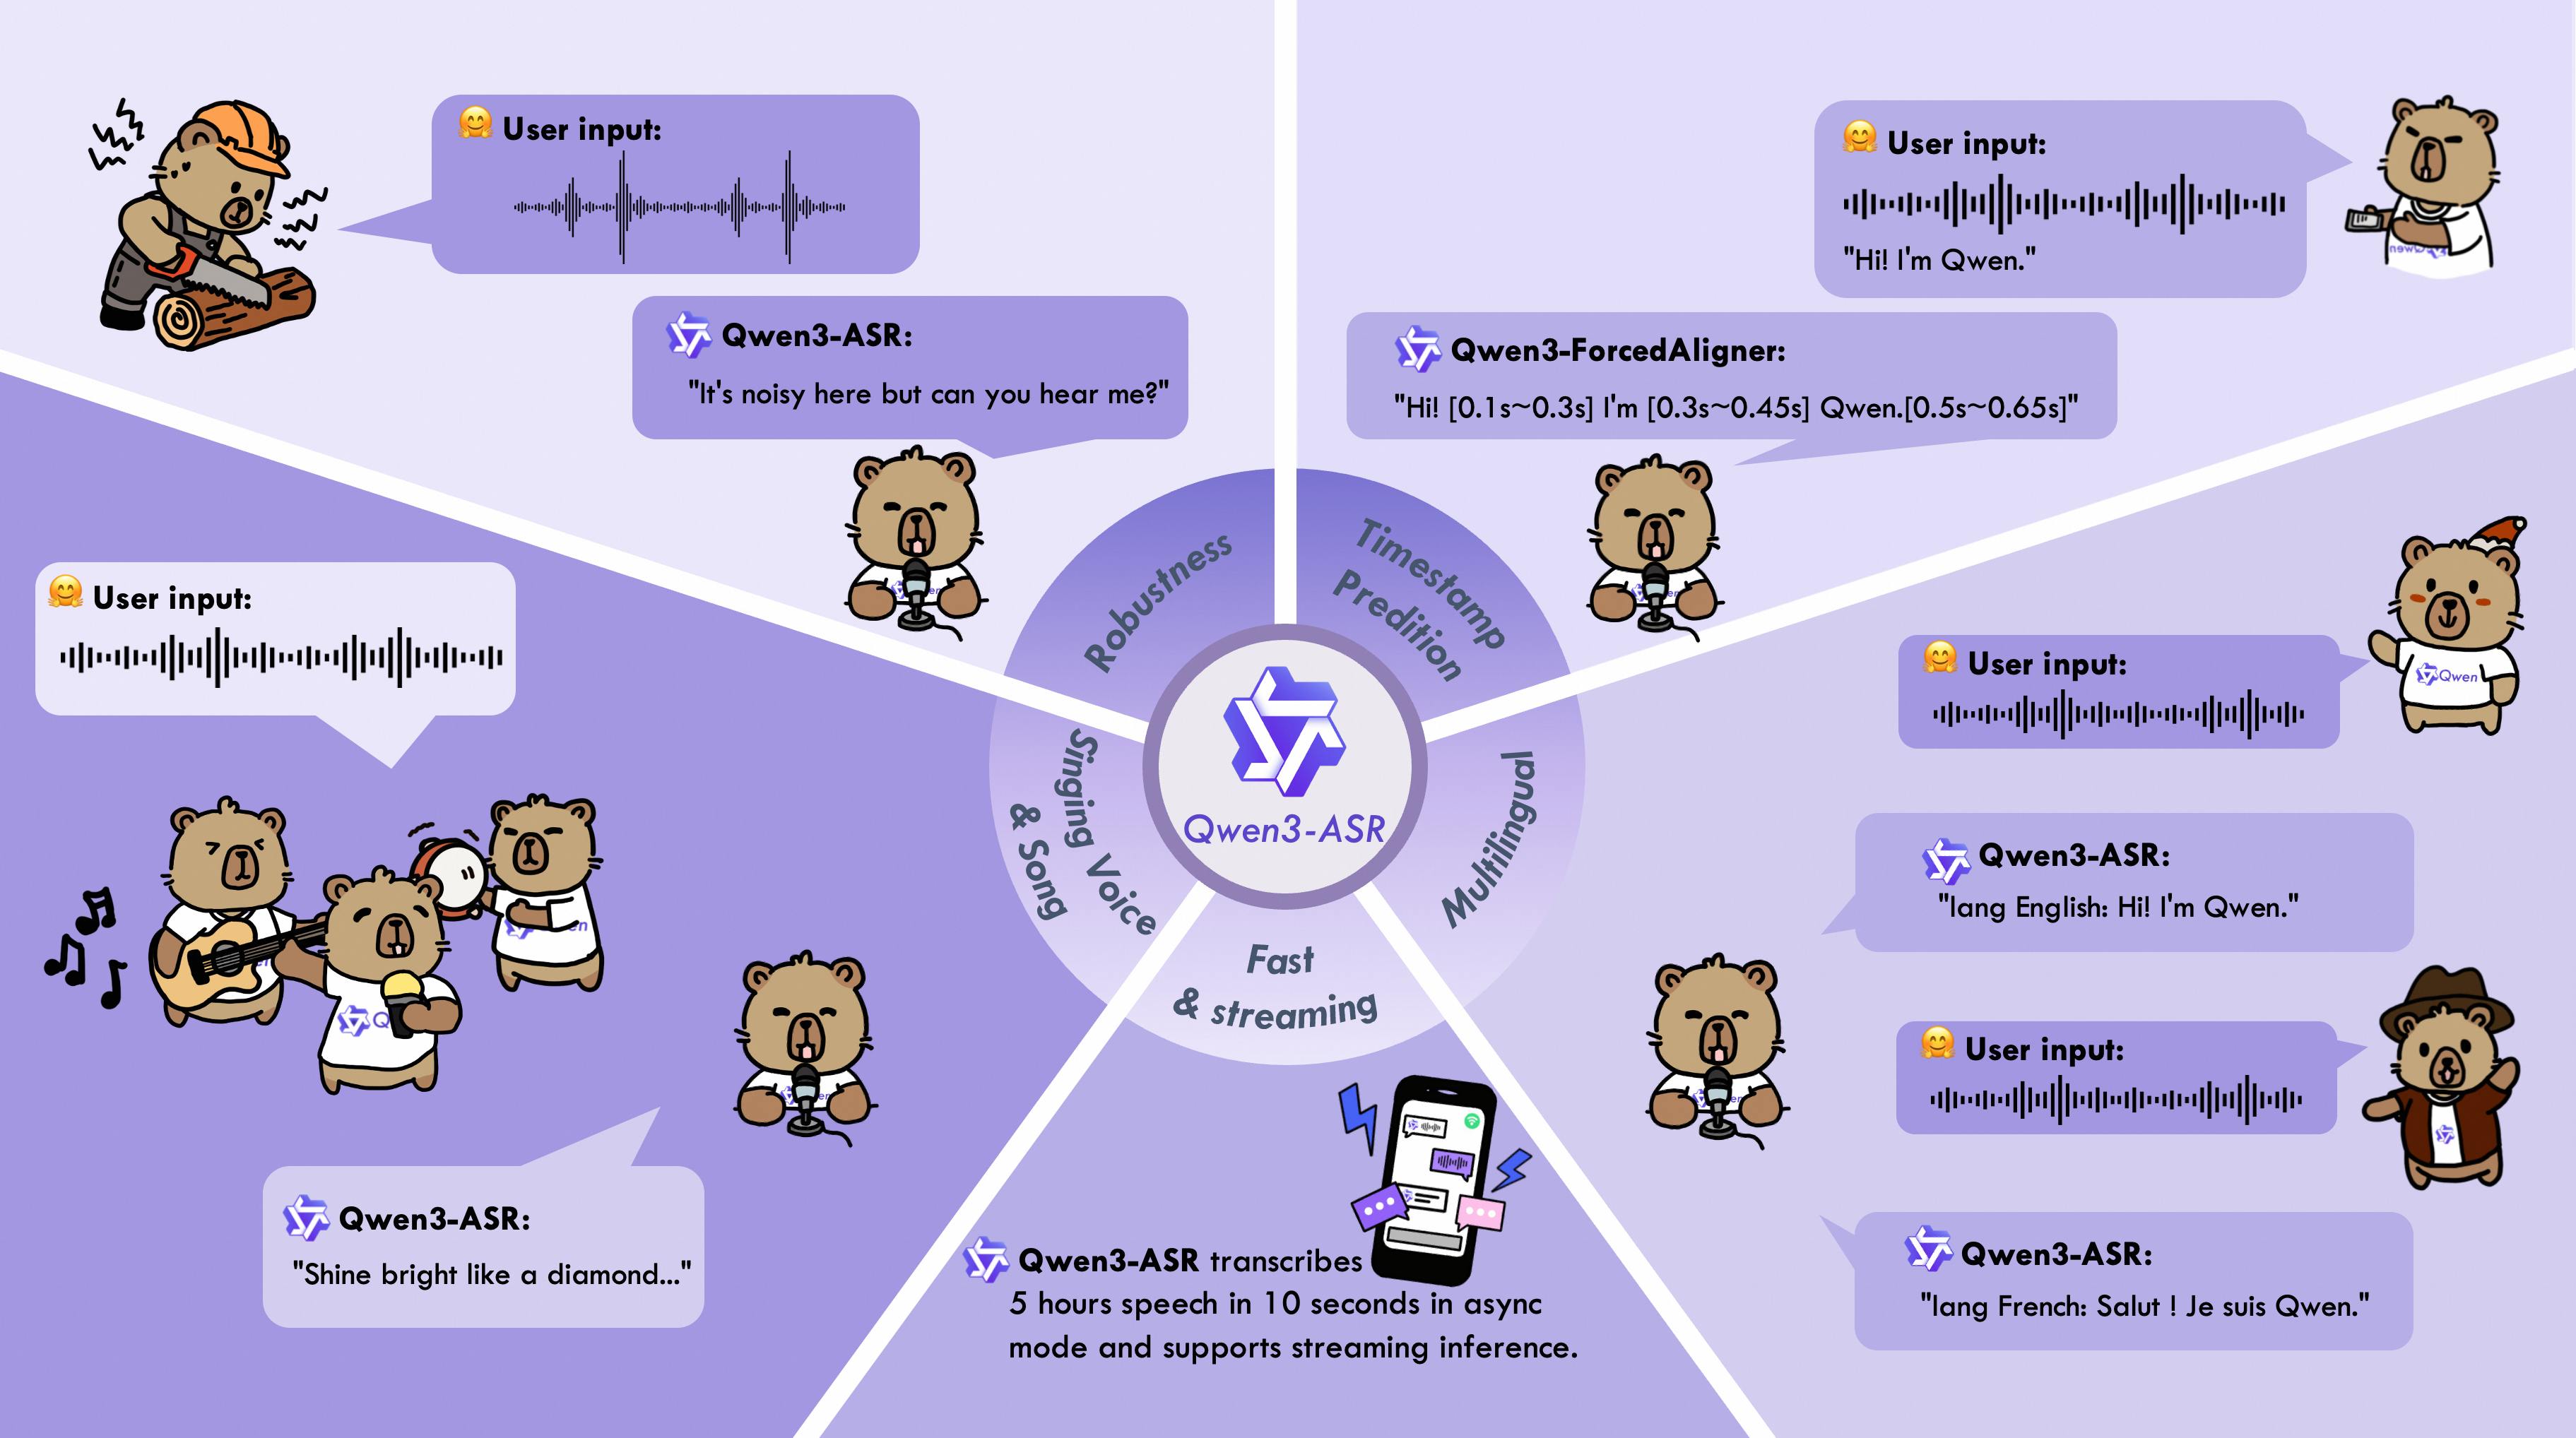
Qwen3-ASR - 开源最强中文语音识别+时间戳对齐
推荐软件
Qwen3-ASR - 开源最强中文语音识别+时间戳对齐
阿里Qwen团队出品,中文WER开源最低,配套ForcedAligner毫秒级时间戳,视频配音翻译链路的基础设施
1个月前
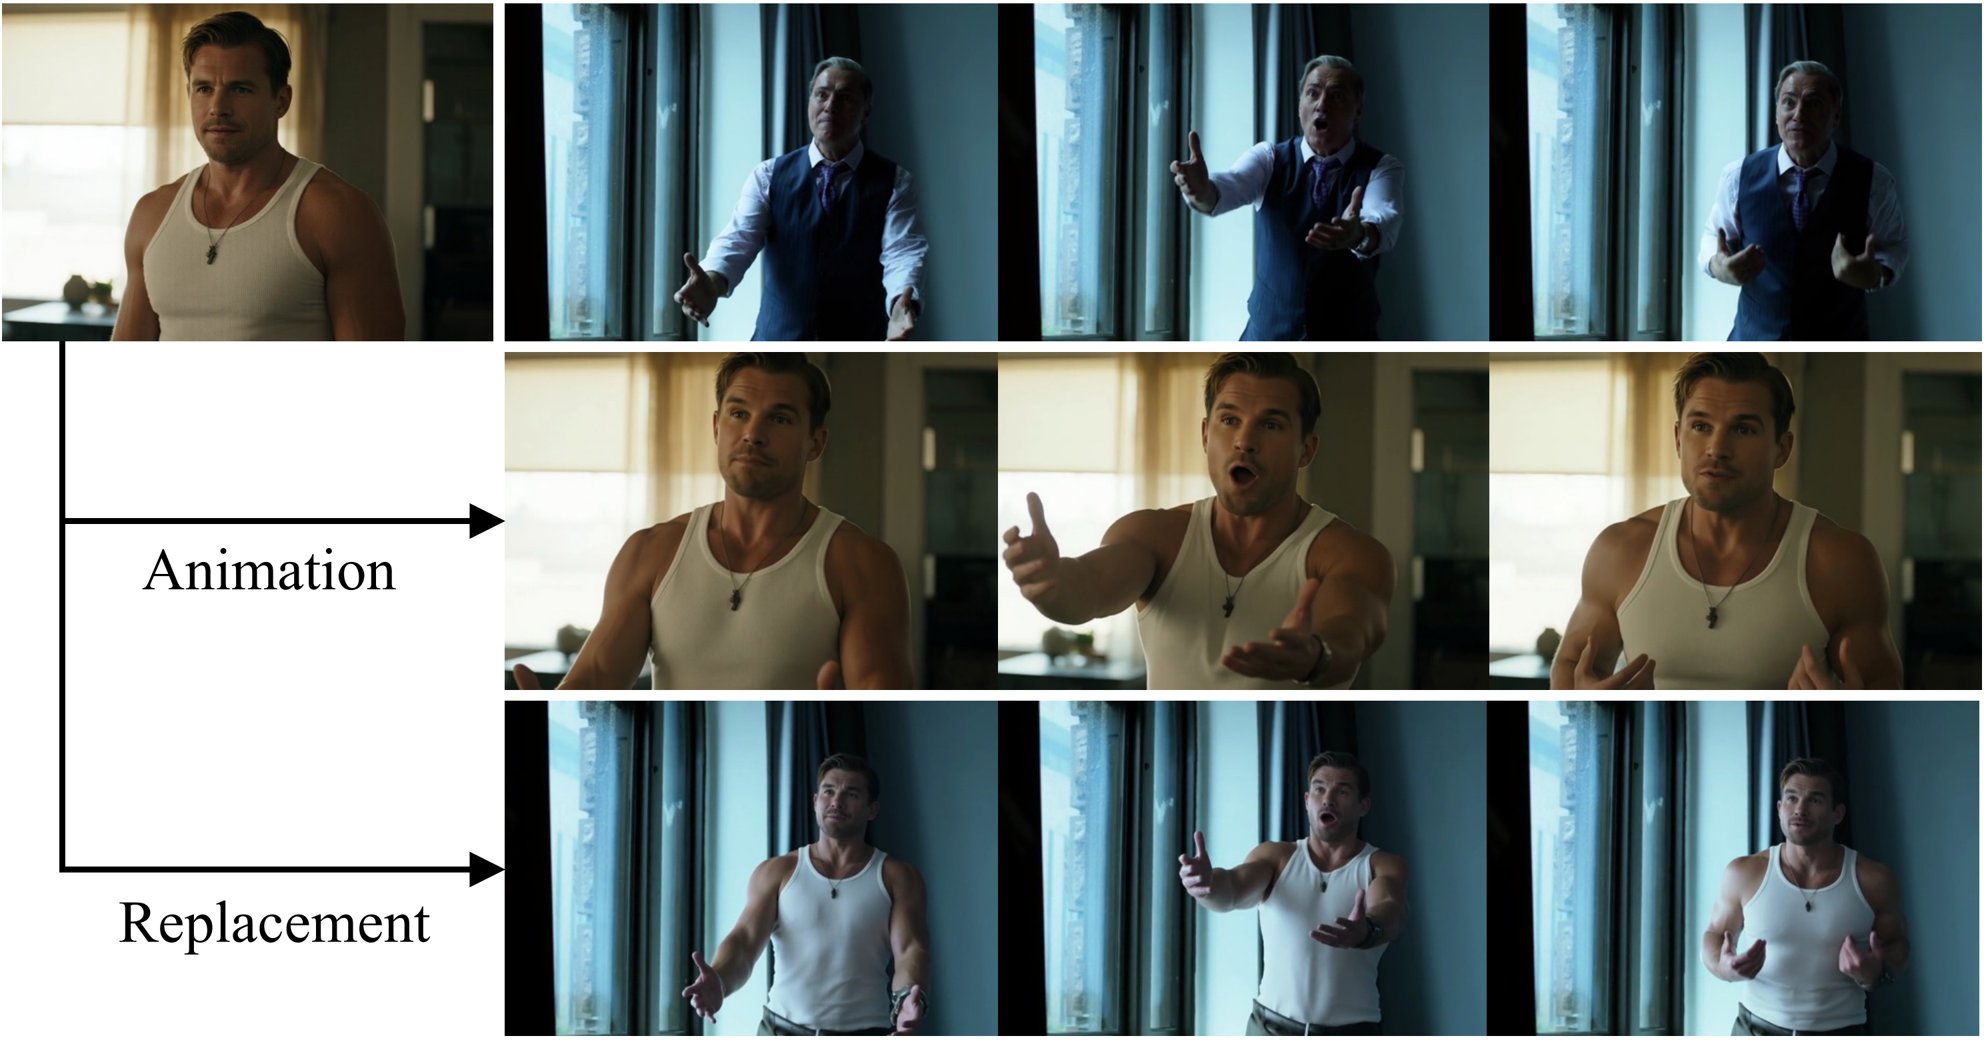
Wan-Animate - 免费AI角色动画与视频换人(阿里万相)
推荐软件
Wan-Animate - 免费AI角色动画与视频换人(阿里万相)
一张图片+一段视频,角色跟随动作表情表演或直接替换视频中人物,骨骼信号+重光照LoRA,免费
1个月前
通义万相 - 阿里AI视频图像生成平台(万相2.6)
推荐软件
通义万相 - 阿里AI视频图像生成平台(万相2.6)
国内首个角色扮演视频生成,文/图生视频、多镜头叙事、音画同步、图文混排绘本,一站式AI创作
1个月前
三大开源 ASR 横评 - VibeVoice-ASR 7B vs Qwen3-ASR vs Whisper
推荐模型
三大开源 ASR 横评 - VibeVoice-ASR 7B vs Qwen3-ASR vs Whisper
Qwen3-ASR 效率碾压、VibeVoice 长音频分人无敌、Whisper 生态覆盖最广——三大 ASR 各守一象限,谁该装谁
1个月前
Video-Subtitle-Remover:AI 本地去字幕/去水印工具 (12.6k Star)
推荐软件
Video-Subtitle-Remover:AI 本地去字幕/去水印工具 (12.6k Star)
基于 STTN/LaMA/ProPainter 等多算法的视频硬字幕和文本水印去除工具,完全本地运行,支持 Windows/Mac/Linux/Docker
1个月前
FLUX 3 - Black Forest Labs 多模态统一模型,图像视频音频一个架构
推荐模型
FLUX 3 - Black Forest Labs 多模态统一模型,图像视频音频一个架构
FLUX 1/2 团队新作:图像/视频/音频联合训练的世界模型,视频+原生音频最长 20 秒,Early Access 已开放
1个月前
MiniMax H3 开源后,视频模型格局要重洗了(主流模型大盘点)
推荐随笔
MiniMax H3 开源后,视频模型格局要重洗了(主流模型大盘点)
首个开源全能参考视频模型:消费级显卡可跑,效果≈Seedance 2.0 Fast 八成、成本仅十分之一。附Seedance/可灵/万相/LTX/Veo/Grok/FLUX3逐家盘点
1个月前
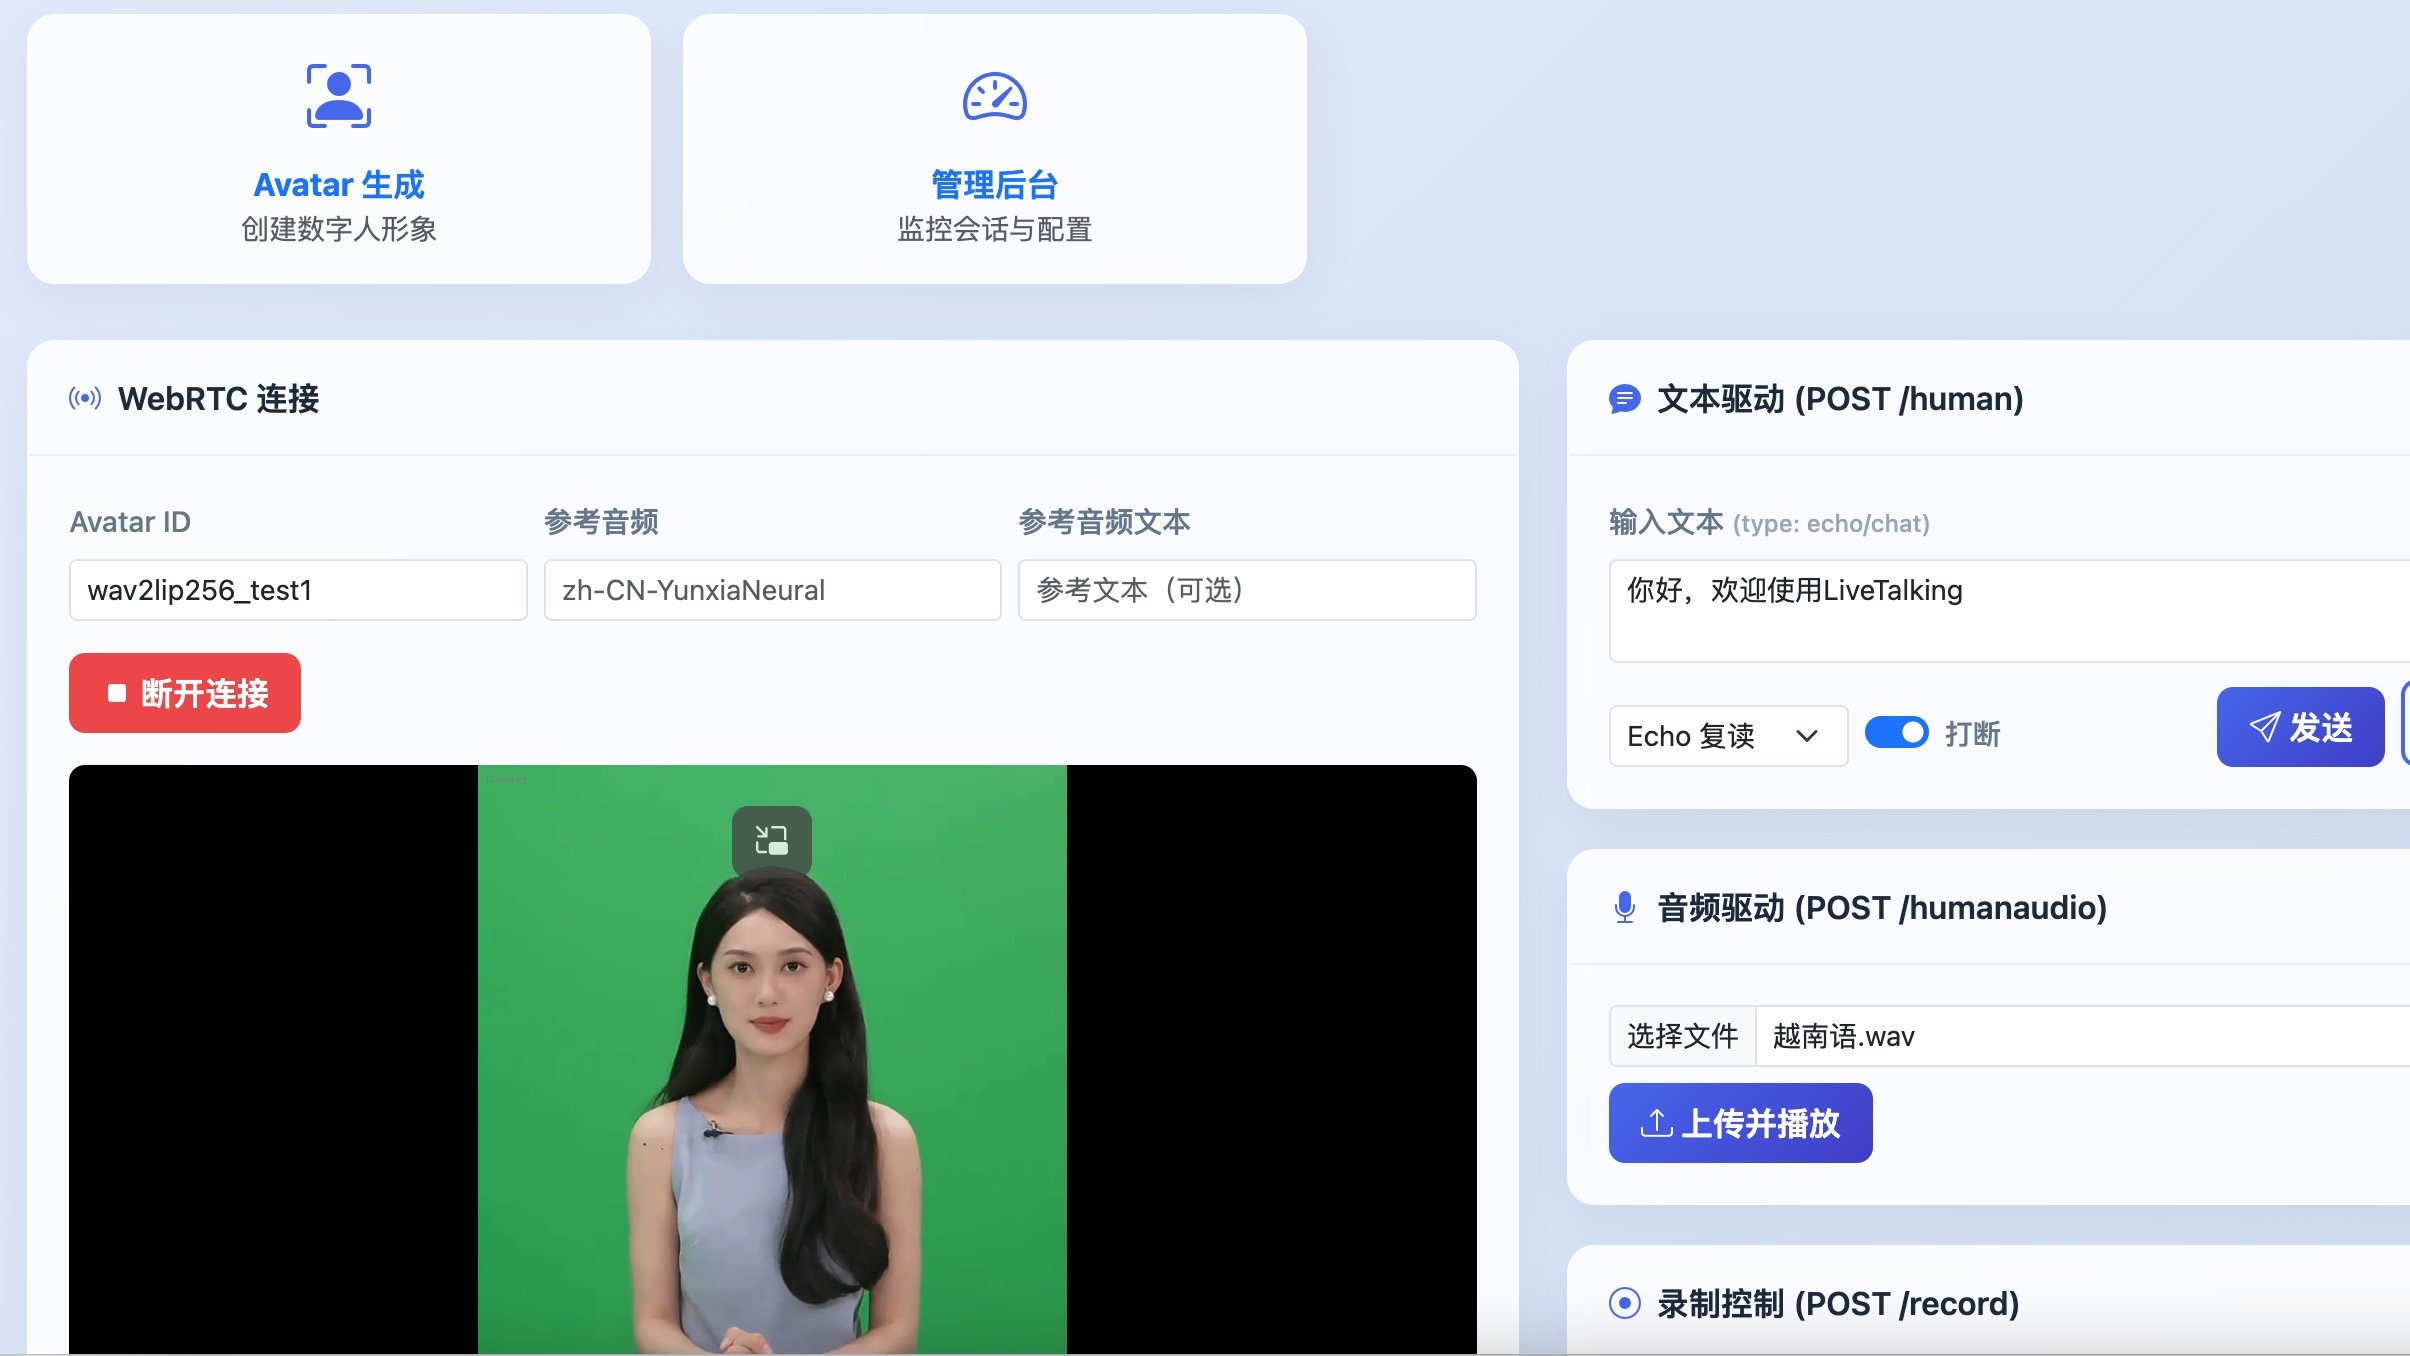
LiveTalking - 实时流式数字人引擎,文本/语音驱动虚拟形象对话
推荐源码
LiveTalking - 实时流式数字人引擎,文本/语音驱动虚拟形象对话
实时交互流式数字人引擎,9.3K Stars。支持 Wav2Lip/MuseTalk/Ernerf 多模型,WebRTC/RTMP/虚拟摄像头输出,已广泛商用
27天前
LivePortrait:快手开源实时肖像动画神器(19k★)
推荐软件
LivePortrait:快手开源实时肖像动画神器(19k★)
一张照片实时驱动表情/姿态,4090 上毫秒级推理,配口型模型可组完整数字人,开源 MIT
27天前
VideoDevour - 视频吃进去,图文报告吐出来
推荐软件
VideoDevour - 视频吃进去,图文报告吐出来
扔一段视频进去,自动出带章节配图的 Markdown 报告,网课笔记/会议纪要/内容素材一站搞定
27天前
FunClip - 按文字剪视频,不用拖时间轴
推荐软件
FunClip - 按文字剪视频,不用拖时间轴
上传视频自动语音转写,选中文字段落就剪出对应片段,还支持按说话人剪辑和 LLM 辅助选段
27天前
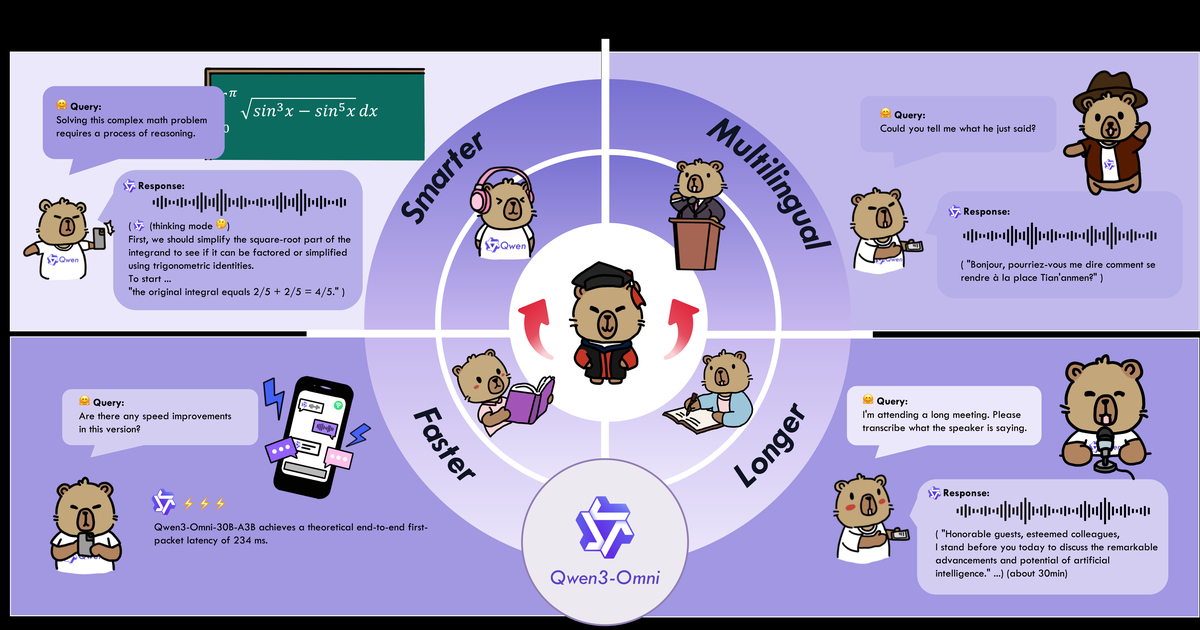
Qwen3-Omni - 30B原生全模态,能看能听还能说
推荐模型
Qwen3-Omni - 30B原生全模态,能看能听还能说
甩一段视频进去,画面内容、背景音乐、音效、对白全给你分析出来——阿里原生全模态模型,30B只激活3B,还能直接用语音回答你,Apache 2.0
27天前
PreenCut:说人话就能剪视频的 AI 检索剪辑工具
推荐软件
PreenCut:说人话就能剪视频的 AI 检索剪辑工具
Whisper转写+LLM语义分析,用自然语言从长视频里找片段、选段、导出成片,检索到剪辑全流程一个Web界面闭环
27天前