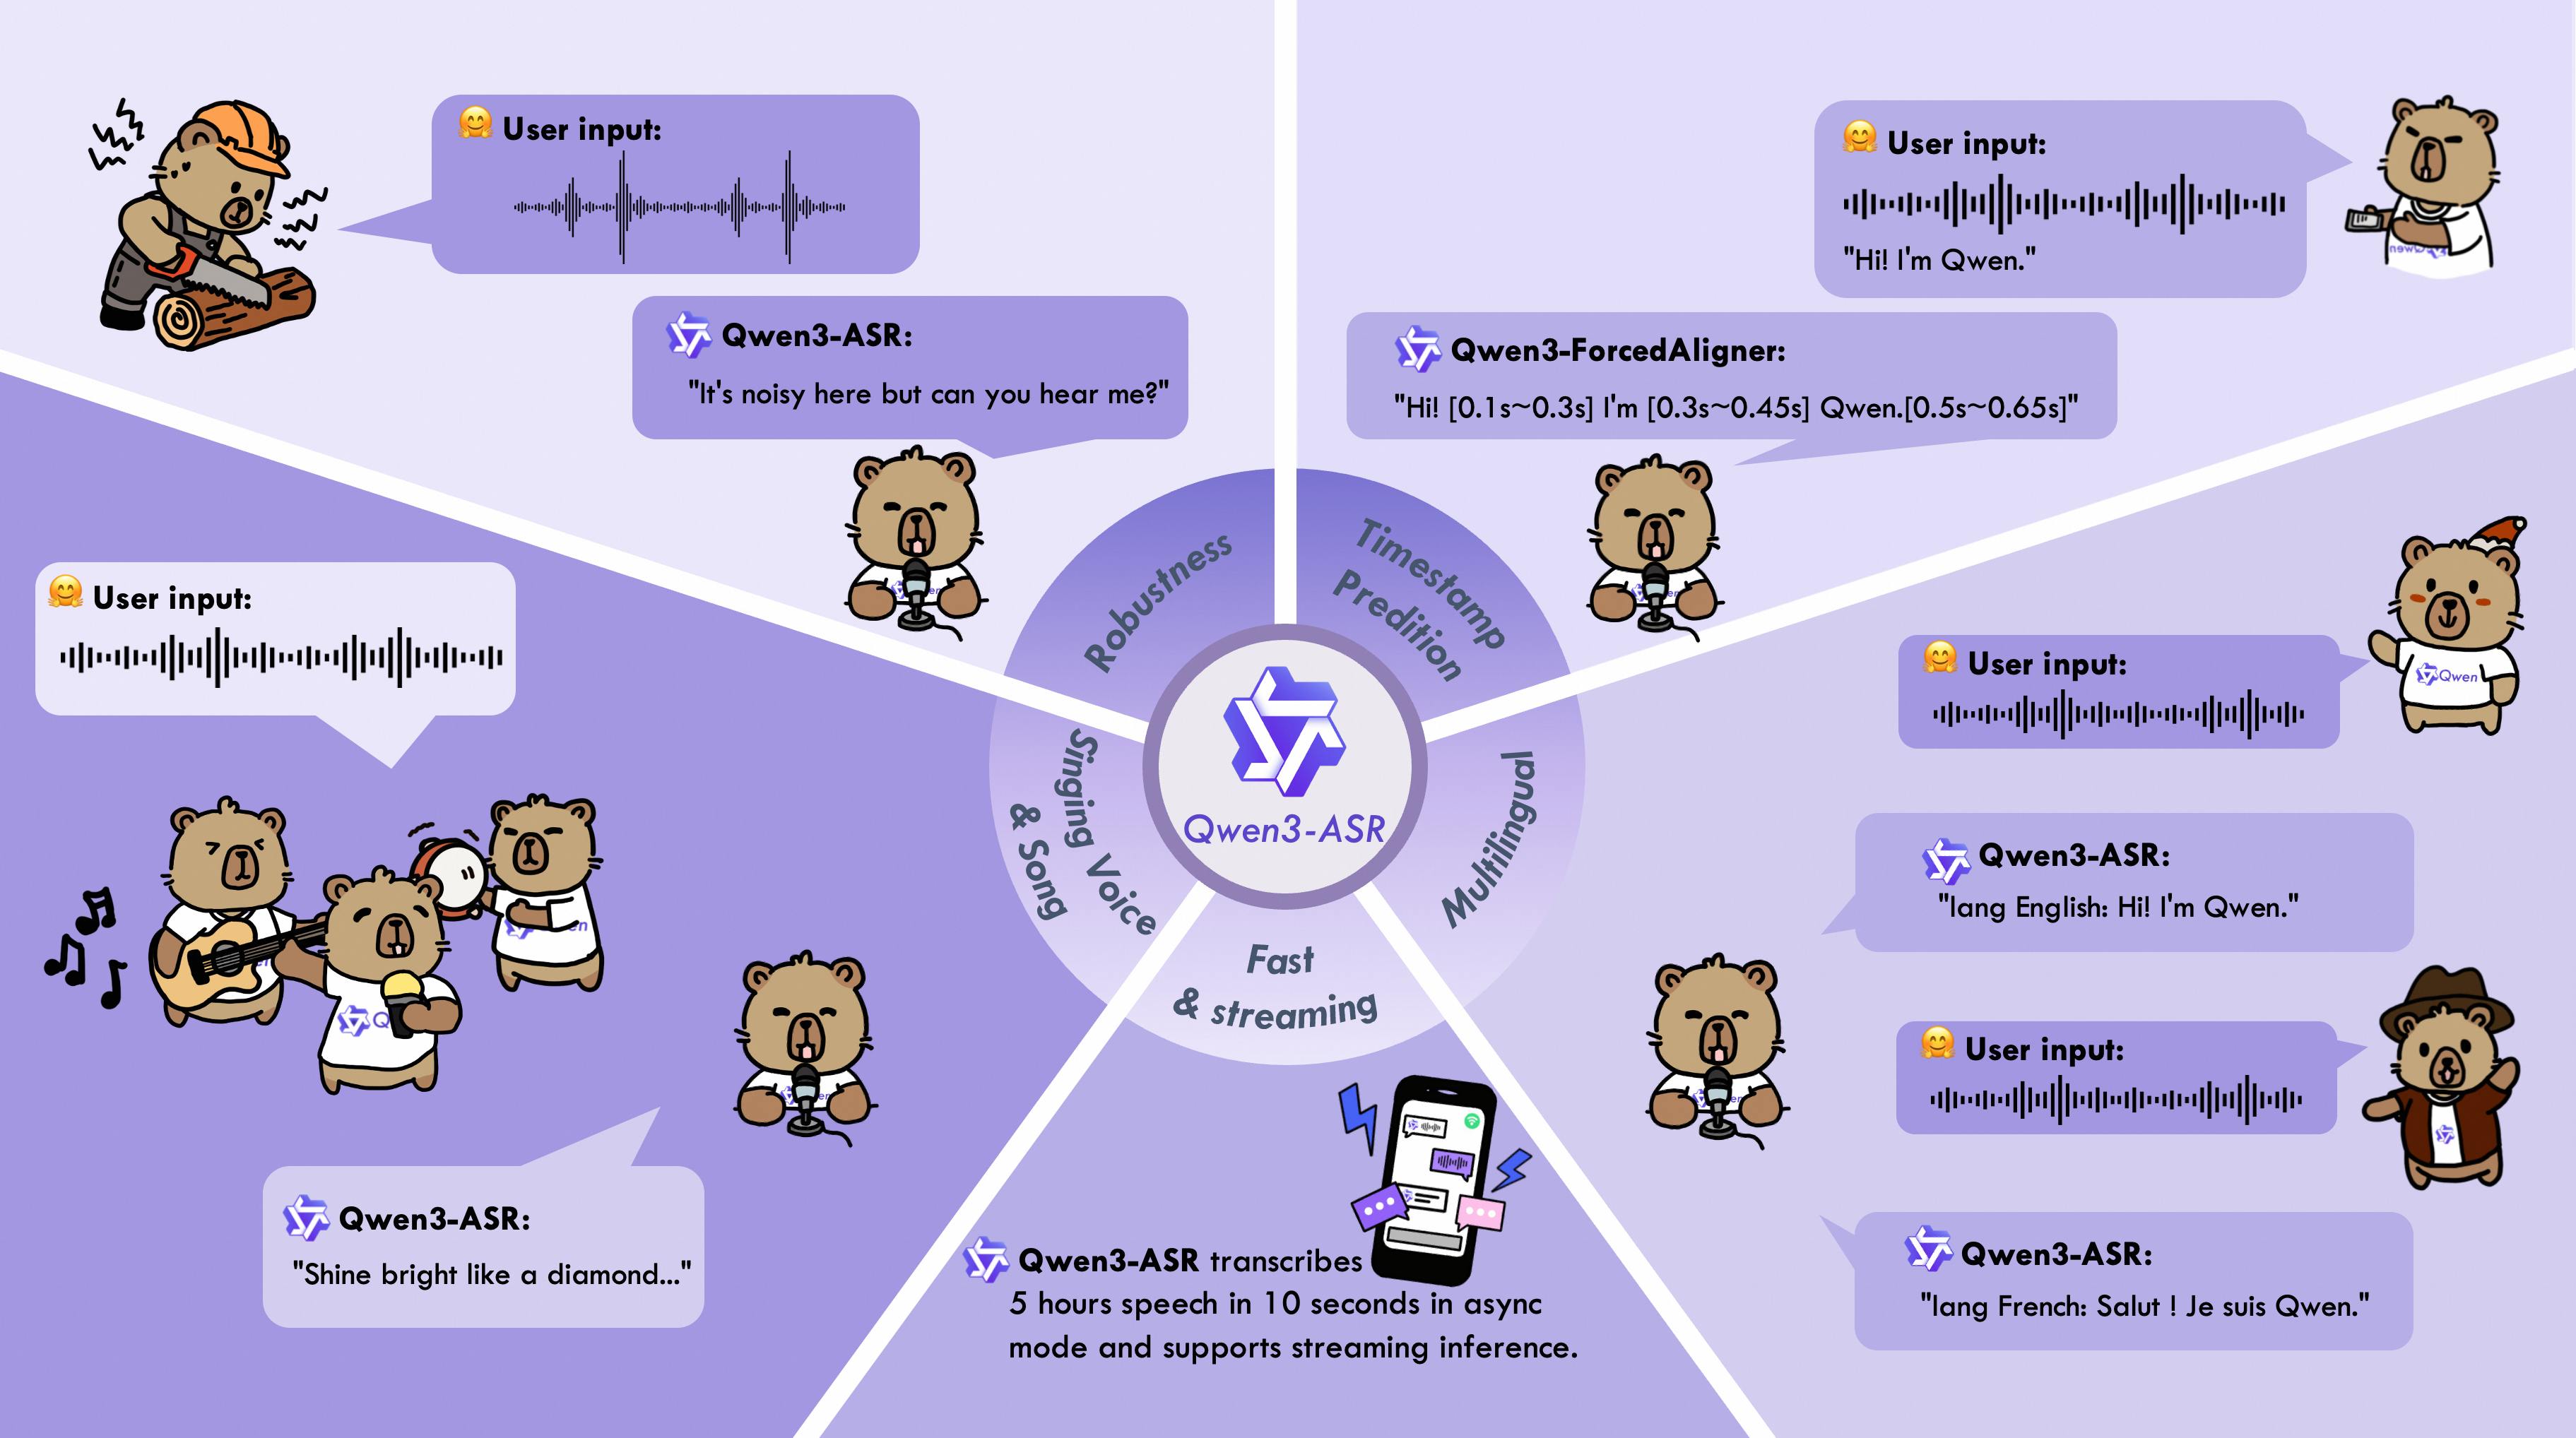
Qwen3-ASR 是阿里 Qwen 团队开源的语音识别模型家族,2026年1月发布,Apache 2.0 许可。包含三个模型:Qwen3-ASR-1.7B、Qwen3-ASR-0.6B(语音转文字)和 Qwen3-ForcedAligner-0.6B(文字-音频时间戳对齐)。
核心能力
52种语言+22种中文方言,包括普通话、粤语、英语、日语、韩语、越南语、阿拉伯语等主流语言,以及安徽话、东北话、四川话、闽南语、吴语等方言。模型内置语言识别,不需要手动指定语言。
中文识别率开源最强。 Qwen3-ASR-1.7B 中文 WER 13.91%,在公开和阿里内部 benchmark 上均超越 Whisper large-v3,与最强的商业 API(GPT-4o-transcribe 等)持平甚至领先。粤语和方言场景优势尤其大。
速度极快。 Qwen3-ASR-0.6B 在 128 并发下可实现 2000 倍实时吞吐,首 token 延迟低至 92ms。1.7B 版本在速度和准确率之间取得了很好的平衡。支持离线和流式两种模式,一个模型统一搞定。
支持唱歌识别和BGM背景。 不只是纯语音,带背景音乐的歌曲也能识别歌词。
ForcedAligner — 配套时间戳对齐模型
Qwen3-ForcedAligner-0.6B 是一个非自回归的时间戳预测模型。输入音频+文字,输出每个字/词的起止时间,精度达到毫秒级。
工作方式: 先用 ASR 模型把语音转成文字,再把文字和原始音频一起喂给 ForcedAligner,就能得到每个字对应的时间戳。官方 Gradio Demo 支持一键启用(加 --aligner-checkpoint 参数即可)。
精度超越所有开源对齐方案。 论文对比了三个最强的端到端对齐模型,Qwen3-ForcedAligner 在时间戳准确率上全面胜出。支持中英日韩法德意葡俄西+粤语共 11 种语言,单次最长处理 5 分钟音频。
实际应用场景
- 视频口播转录: 抖音/小红书/B站视频的口播内容提取,生成带时间戳的字幕
- 视频翻译配音: 原语言转写+时间戳对齐→翻译→目标语言TTS→按时间轴合成,整个链路的基础
- 会议/播客转录: 长音频离线批量处理
- 实时语音输入: CapsWriter-Offline 等工具已集成 Qwen3-ASR 作为可选引擎
- 字幕生成: 视频自动加字幕
部署
提供 qwen-asr Python 包,支持 Transformers 和 vLLM 两种后端。vLLM 后端适合高并发服务部署,Transformers 后端适合单机使用。还提供 Gradio Web Demo(qwen-asr-demo 命令一键启动)和 Docker 部署方式。模型支持 PyTorch、MLX(Apple Silicon)和 vLLM 推理。
显存需求: ASR-1.7B 约 4GB,ForcedAligner-0.6B 约 1.5GB(bf16)。两个模型不同时推理,峰值取较大的即可。普通 GPU 就能跑。
生态
- GitHub 3.4k+ Stars
- HuggingFace / ModelScope 同步托管
- 阿里云 DashScope API 可直接调用(免部署)
- 2026年6月新增原生 Transformers 支持,含
torch.compile加速 - 社区已有多款工具集成(CapsWriter-Offline、KrillinAI 等)
和 Whisper 的关系
Whisper 仍然是生态最成熟、工具链最完善的选择,支持 99 种语言。但 Qwen3-ASR 在中文和粤语识别率上明显领先,速度快几个数量级,且 ForcedAligner 的时间戳精度是 Whisper 的 word-level timestamp 无法比拟的。新建中文语音识别项目优先考虑 Qwen3-ASR,已有的 Whisper 部署如果有中文准确率瓶颈也值得切换。


暂无评论