站内搜索「Qwen3.8」共 62 条结果
推荐模型
Qwen3.8-27B - 27B多模态新王,终端编程超Opus 4.6 MaxQwen3.6-27B正统后继:原生多模态+混合线性注意力架构,262K上下文,终端编程基准超Opus 4.6 Max,Apache 2.0可商用,量化后16GB内存可跑
1个月前
推荐模型
Qwen3.8-27B 去审查版首选:OrcaRouter Uncensored十几个去审查版里口碑最干净的一版,MLX 786赞/FP8 715赞双第一,红队探针0拒绝且不变笨;附 JonathanColetti/OBLITERATUS/huihui 等6家横评
1个月前
推荐硬件
M5 Max 实测 Qwen3.8-27B MLX 4bit 并发扩展性:1→32 并行全数据64GB 统一内存本地跑 27B,252 次请求零报错。低并发看响应,高并发看总量,甜蜜区在 N≤4
28天前
推荐软件
GSQ-RCO:ISTA研究所的非均匀量化,11.8GB跑出BF16满分的Qwen3.8-27B学术派量化天花板:每个张量单独分配精度,同体积比Unsloth高10分,论文代码全公开可自己复刻
5天前
推荐程序员
NInfer - 只认RTX 5090的Qwen3.8-27B极限推理引擎(从零手搓CUDA,单卡并发破千tok/s)从零手搓的C++/CUDA推理引擎,只认RTX 5090一张卡:Qwen3.8-27B八路并发767 tok/s、AIME双96.7%不掉点,240K上下文还能看图看视频,5090党的天花板玩法。
8天前
推荐模型
Bonsai 2 27B - 54GB压到5.9GB还留98%智力的三值模型(Qwen3.8-27B官方压缩,笔记本能跑满血27B推理)发布3天下载破150万!54GB的Qwen3.8-27B压到5.9GB还留98.2%智力,传统2bit崩掉的数学题它守住95分,低比特本地部署天花板。
8天前
推荐模型
Mac 上跑本地大模型:该选哪个版本、免审模型用哪个(附下载地址与实测速度)同一个模型有 4bit/8bit/免审版,怎么选?一句话:稠密选小、MoE 选大。附下载地址与实测速度;2026-09 补测 oMLX 引擎,修正「换引擎不会变快」的旧结论。
7天前
推荐模型
NVIDIA 上跑本地大模型:一张 3090 Ti 跑 27B 免审模型(附下载地址与实测对照)一张 3090 Ti 跑 27B 免审模型:改写/翻译类比原双卡快 2.2 倍,日常对话快 32%。代价是量化从 8 位降到 4 位,且质量尚未验证。
5天前
推荐软件
Unsloth Dynamic GGUF:新模型发布当天就能跑,510万人下载的量化生态闭环不只量化更是全链路:Dynamic v3.0动态精度+MTP投机解码+Flash Attention加速,llama.cpp/Ollama一键起
5天前

推荐模型
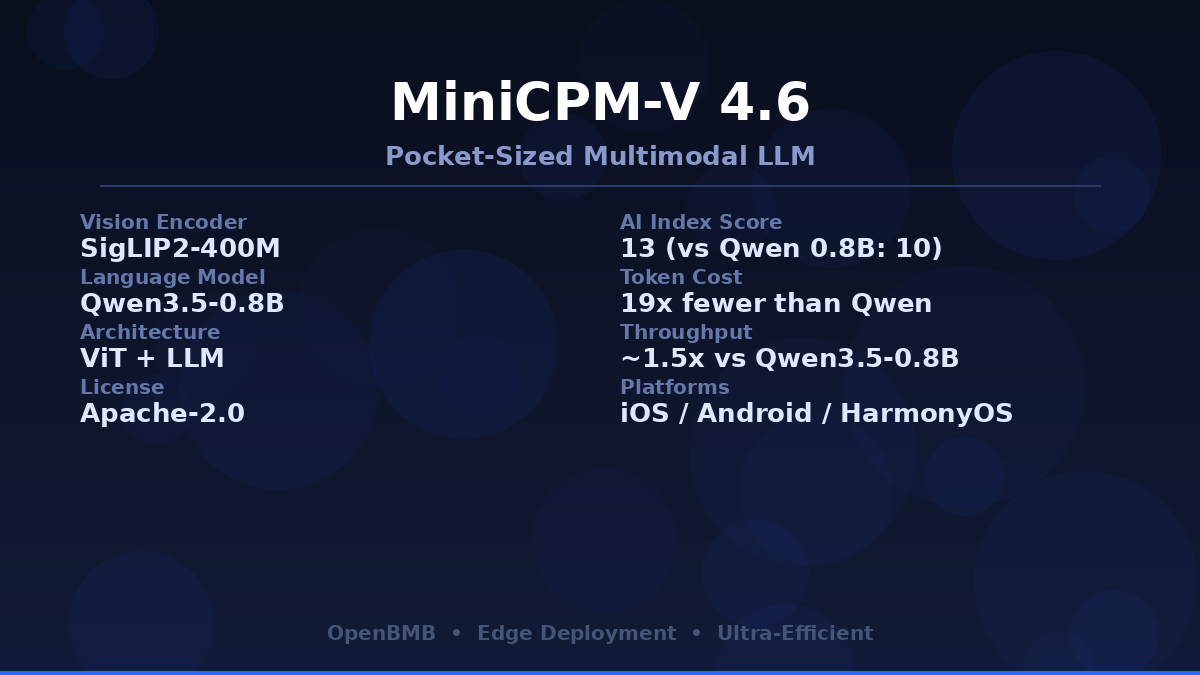
MiniCPM-V 4.6 - 口袋级多模态大模型,手机端部署的超高效视觉语言模型OpenBMB超轻量多模态模型,SigLIP2+Qwen3.5-0.8B,AI Index 13分,三端手机部署
3个月前
推荐模型
WeMM-Embedding:微信开源的多模态向量模型微信视觉团队出品,Apache-2.0 可商用——2B 打赢别家 8B,MMEB-v2 新 SOTA;Matryoshka 可变维度,256 维保住 98.7% 性能,视频号/朋友圈搜索同款技术
1个月前

推荐模型
Kimi 开源 K2.6:1万亿参数 MoE,长程编码与 Agent Swarm 能力行业领先Moonshot AI 开源 Kimi K2.6,1万亿参数 MoE(激活32B),原生多模态。在 SWE-Bench Pro、长程编码、Agent Swarm 等关键指标上超越 Claude Opus 4.6 和 GPT-5.4。开源模型做到这个水平,闭源阵营的压力来了。
5个月前
推荐MacOS
Rapid-MLX - 专为 Apple Silicon 打造的极速本地 AI 引擎比 Ollama 快 4.2 倍,17 种工具调用解析器,0.08 秒首字延迟,完整兼容 OpenAI API
4个月前
推荐模型
三大开源 ASR 横评 - VibeVoice-ASR 7B vs Qwen3-ASR vs WhisperQwen3-ASR 效率碾压、VibeVoice 长音频分人无敌、Whisper 生态覆盖最广——三大 ASR 各守一象限,谁该装谁
1个月前